



































AI RAG 项目从 0 到 1 踩坑:大多数团队卡在检索质量,我整理了一套可直接复用的评估清单 + Prompt 库
很多团队搭完RAG Demo成效不错,一上真实业务就翻车:换个说法、多版本文档、News歧义,回答就开始胡说八道。反复调参几周依然不稳定,本质议题不在模型,而在检索质量。本文梳理RAG检索全链路的7个高频坑点,提供一套可直接上手的检索质量评估框架与分层Prompt体系,帮你从源头解决RAG落地难题。
最近半年接触了十多个内部知识库、企业文档问答、行业资料问答类 RAG 项目,发现一个非常扎心的共性:
很多班底兴冲冲搭完向量库、接入大模型,Demo 演示看着效果不错,一上真实业务就翻车。使用者提问稍微换个说法、文档存在多版本、内容有歧义,回答就开始胡说八道、答非所问、漏关键信息。
很多人第一反应:换更强的大模型、调高 chunk 分片大小、换 embedding 模型。反复调参几周,成效依然不稳定。本质状况根本不在模型,而在检索品质。
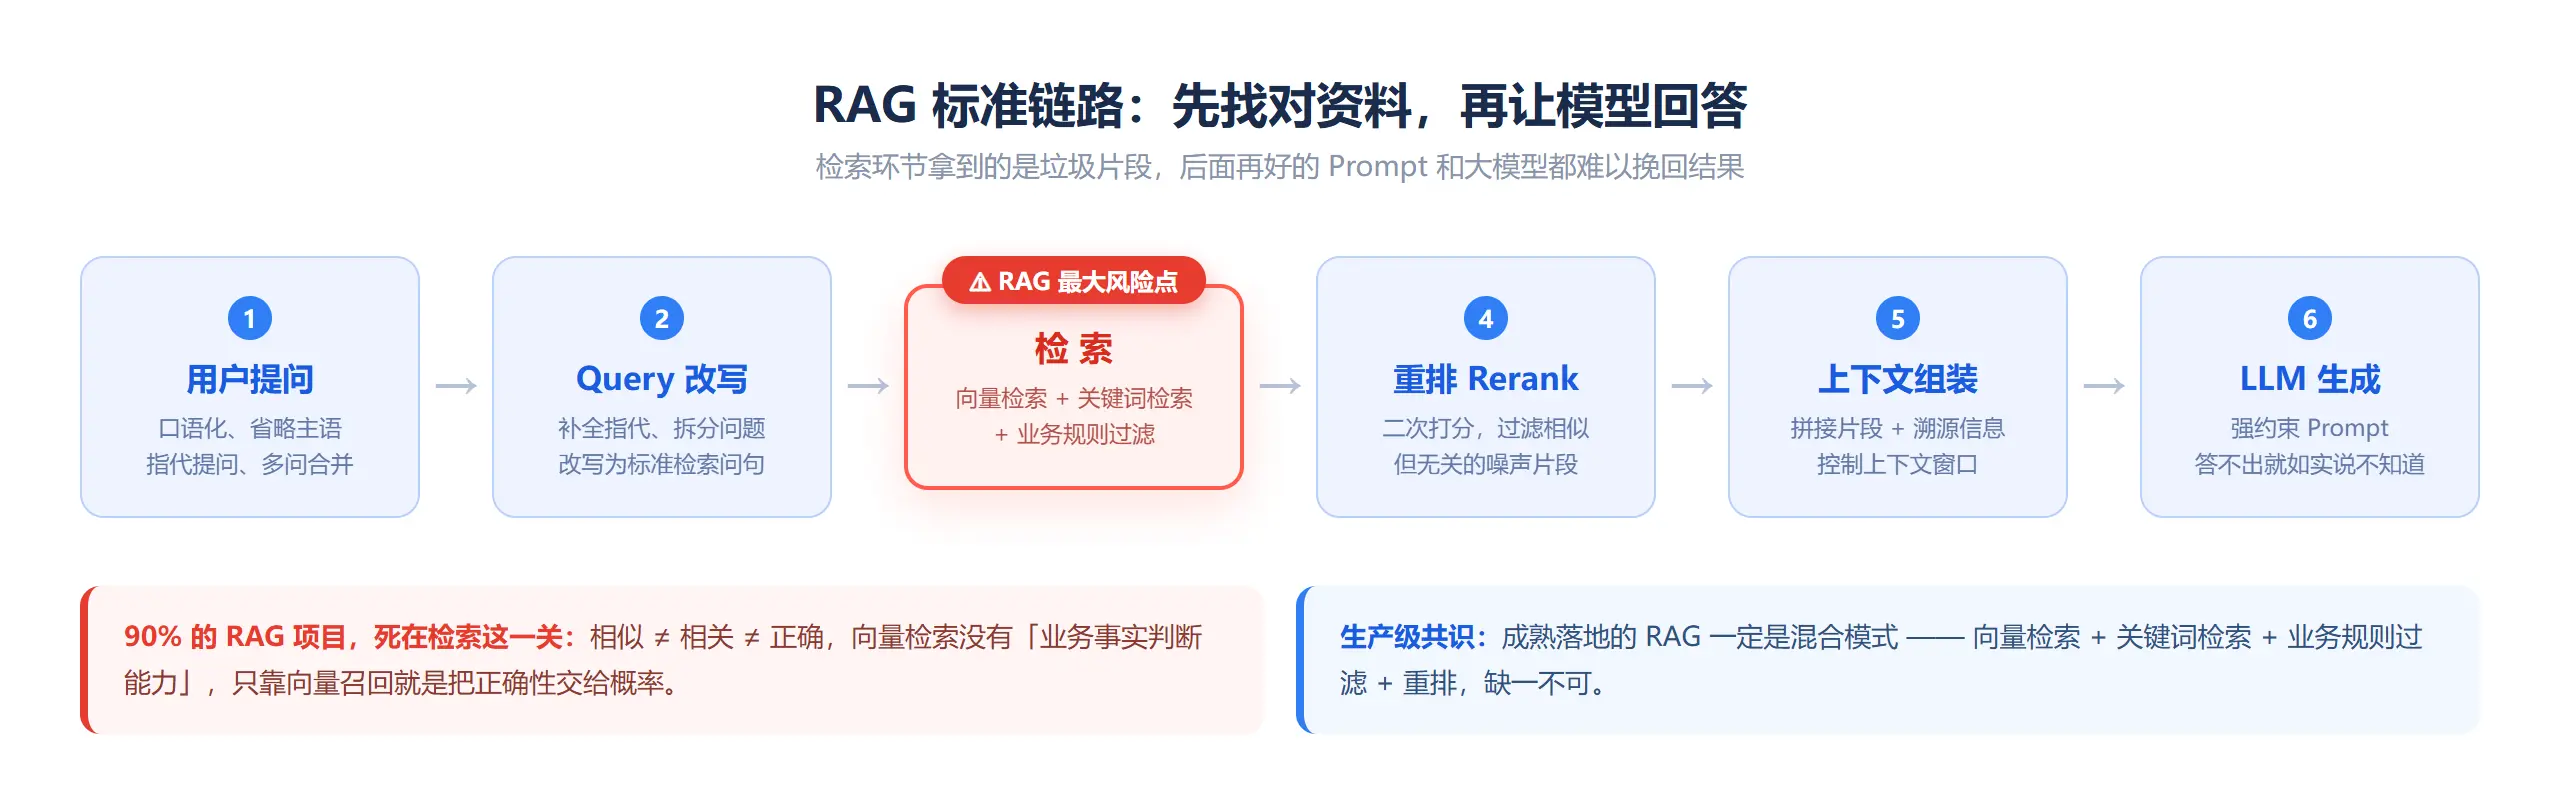
RAG 的核心逻辑是:先找对资料,再让模型基于资料回答。检索环节拿到的是垃圾片段,后面再好的 Prompt 和大模型,都很难挽回结果。以我接触的项目来看,绝大多数卡在检索这一关。
本文不讲花哨的架构,聚焦落地视角:梳理 RAG 检索全链路高频坑点、一套可直接上手的检索质量评估框架、配套的 Prompt 体系。文章里思路、途径、判断标准All公开; 文中展示的是样例清单和精简 Prompt,完整可直接导入使用的评估打分表、多场景 Prompt 库打包整理好了,文末会Description获取方式。
一、先纠正一个误区:检索 ≠ 向量相似度匹配
刚上手做 RAG 的新品,很容易陷入一个认知陷阱:
只要向量相似度分数高,代表检索出来的片段就是对的。
这是所有坑的源头。
向量相似度,衡量的只是「文本语义相近程度」,不等于信息和用户议题相关、不等于信息准确、不等于片段包含答案。
举几个业务里真实遇到的场景:
- 用户问【2025 年项目验收标准】,库里面有【2023 年验收标准】,两段文档描述句式高度相似,向量分很高,检索优先召回旧版本文档;
- 客户问报销审批流程,文档里多处出现”审批”Keyword,向量召回一堆无关制度,只是词语相近;
- 一份方案分上下两 articles, 答案分散在两个 chunk,单次检索只召回其中一段,信息残缺;
- 文档里存在正反两种描述(注意事项、禁止topics款),模型拿到片段只看半句,反向理解规则。
向量检索擅长语义模糊匹配,但是它没有”业务事实判断能力”。只靠向量检索做召回,就是把正确性交给概率。
成熟落地的 RAG,检索一定是混合模式:向量检索 + Keyword检索 + 业务规则过滤 + 重排。而评估检索质量,也不能只看相似度分数。
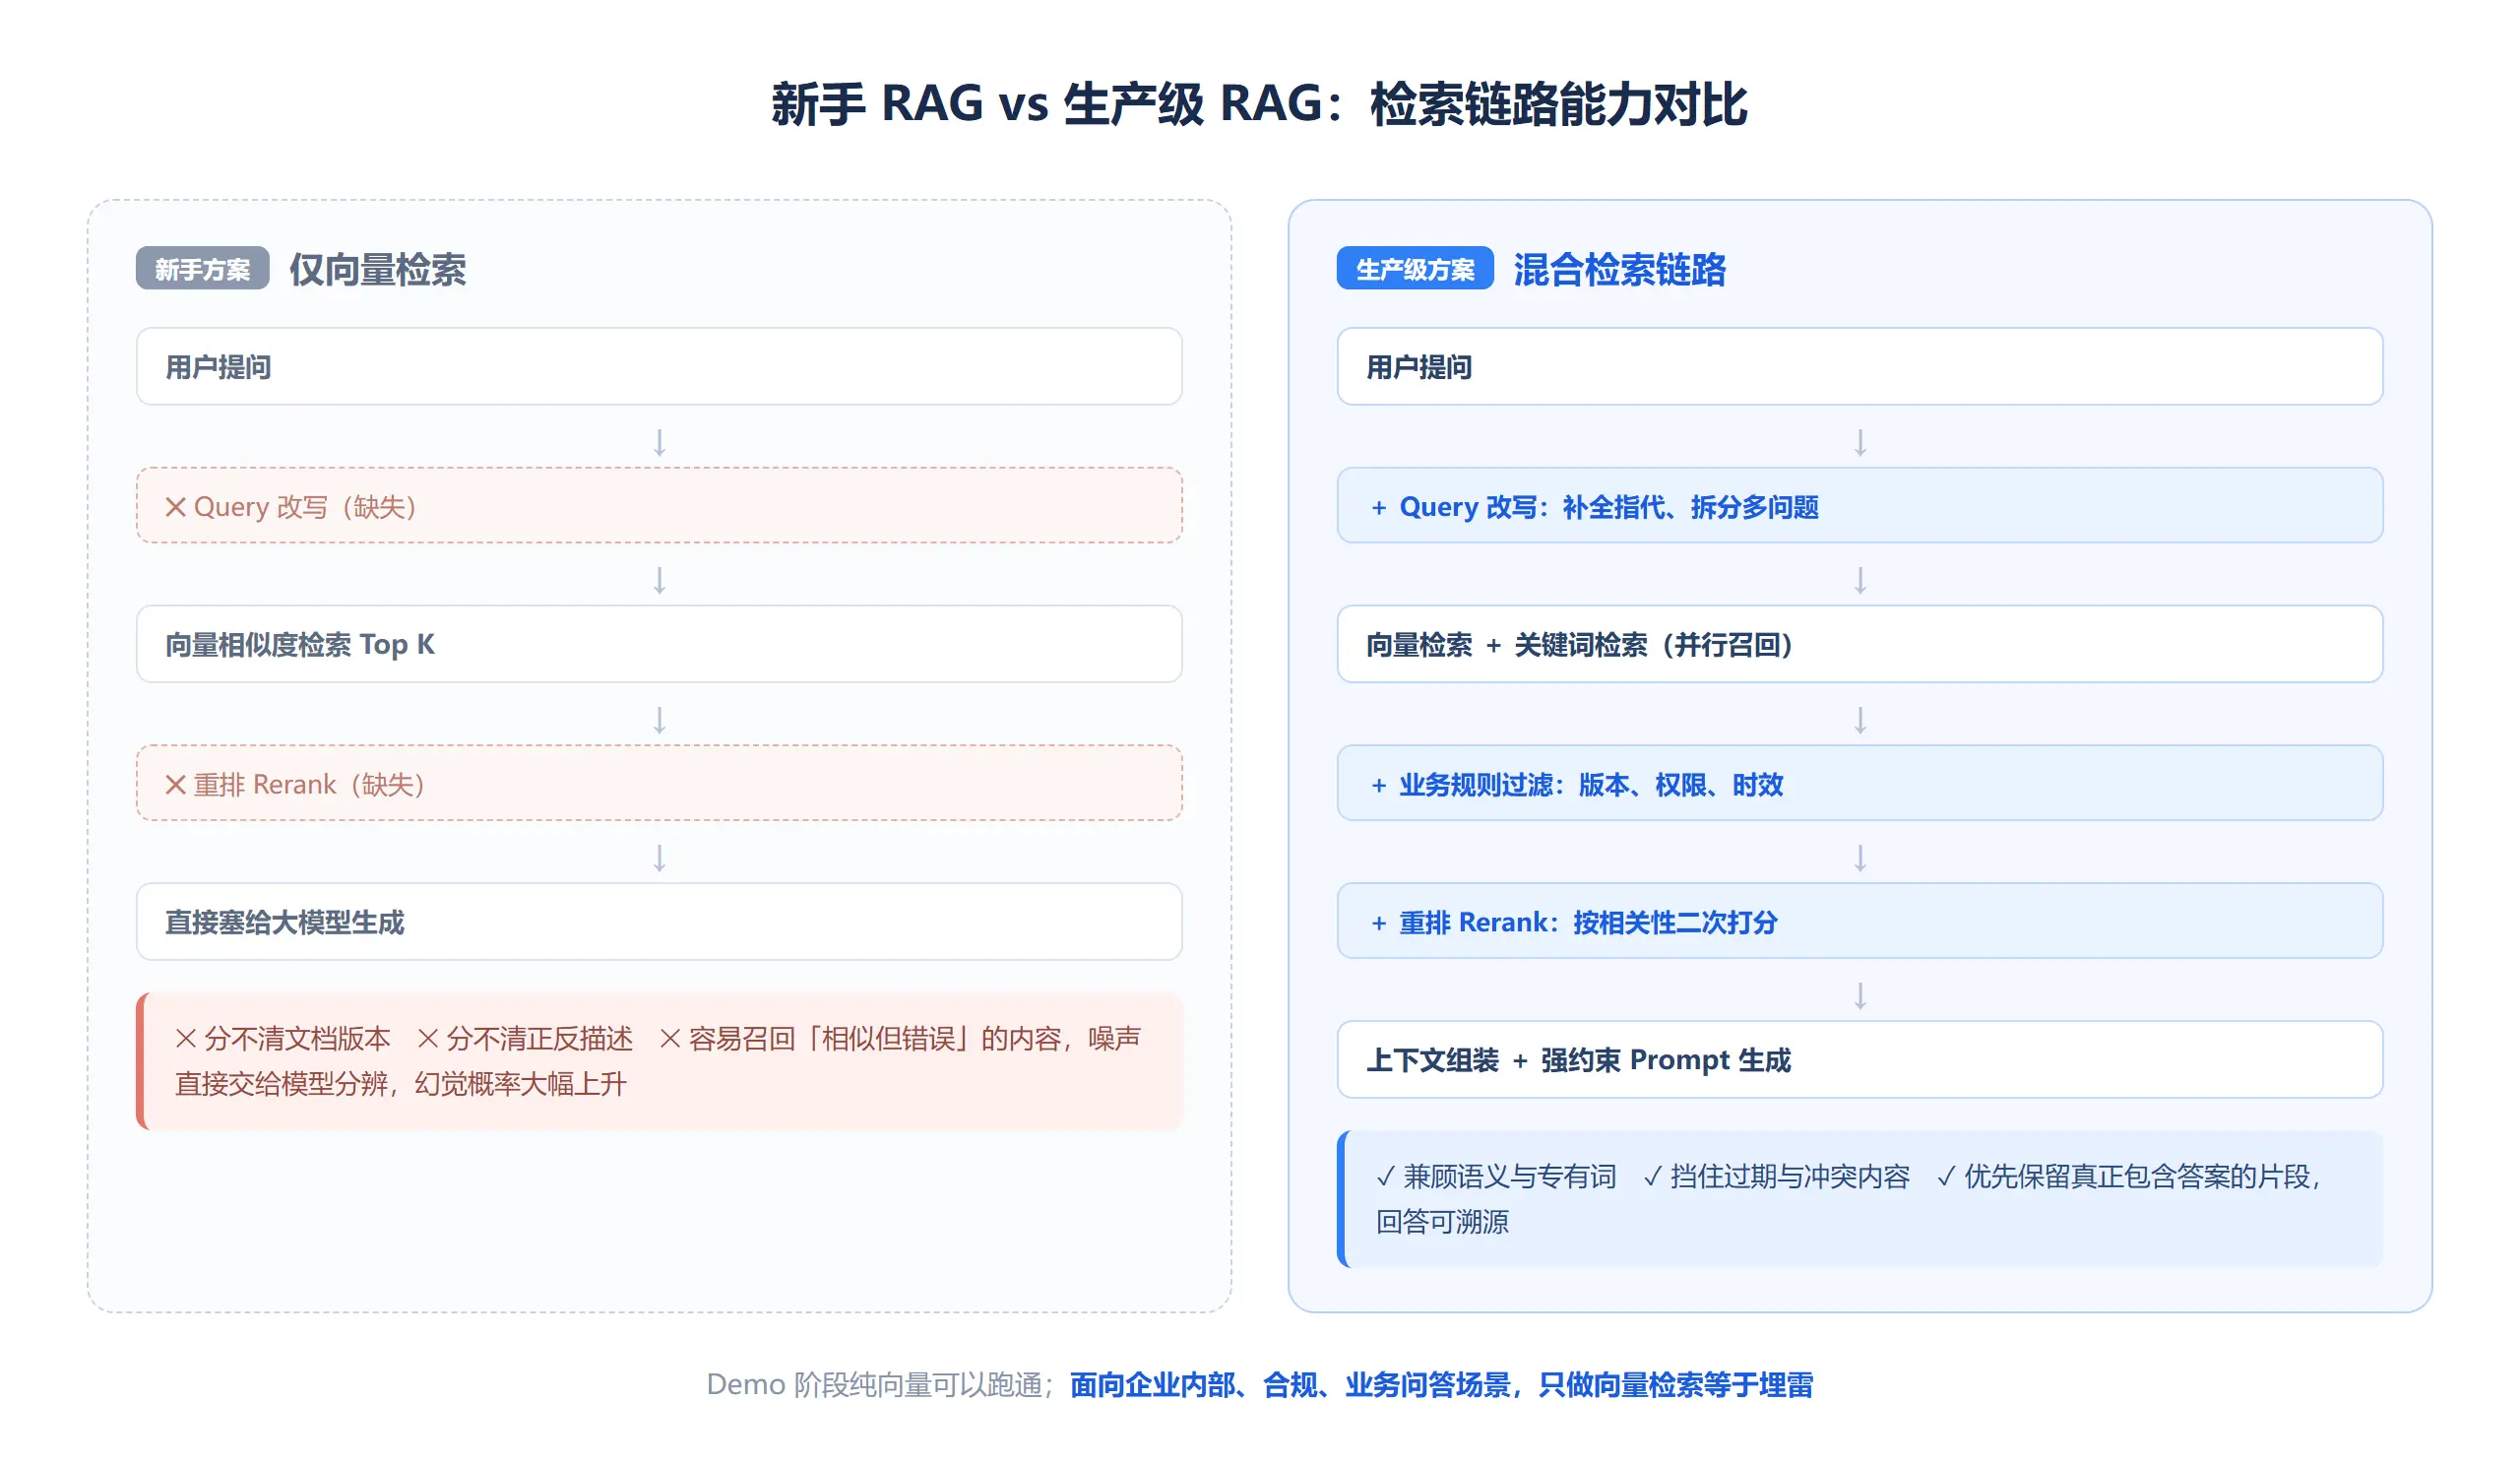
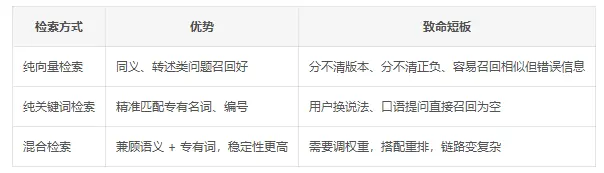
产品小结: Demo 阶段纯向量可以跑通; 面向企业内部、合规、业务问答场景,只做向量检索等于埋雷。
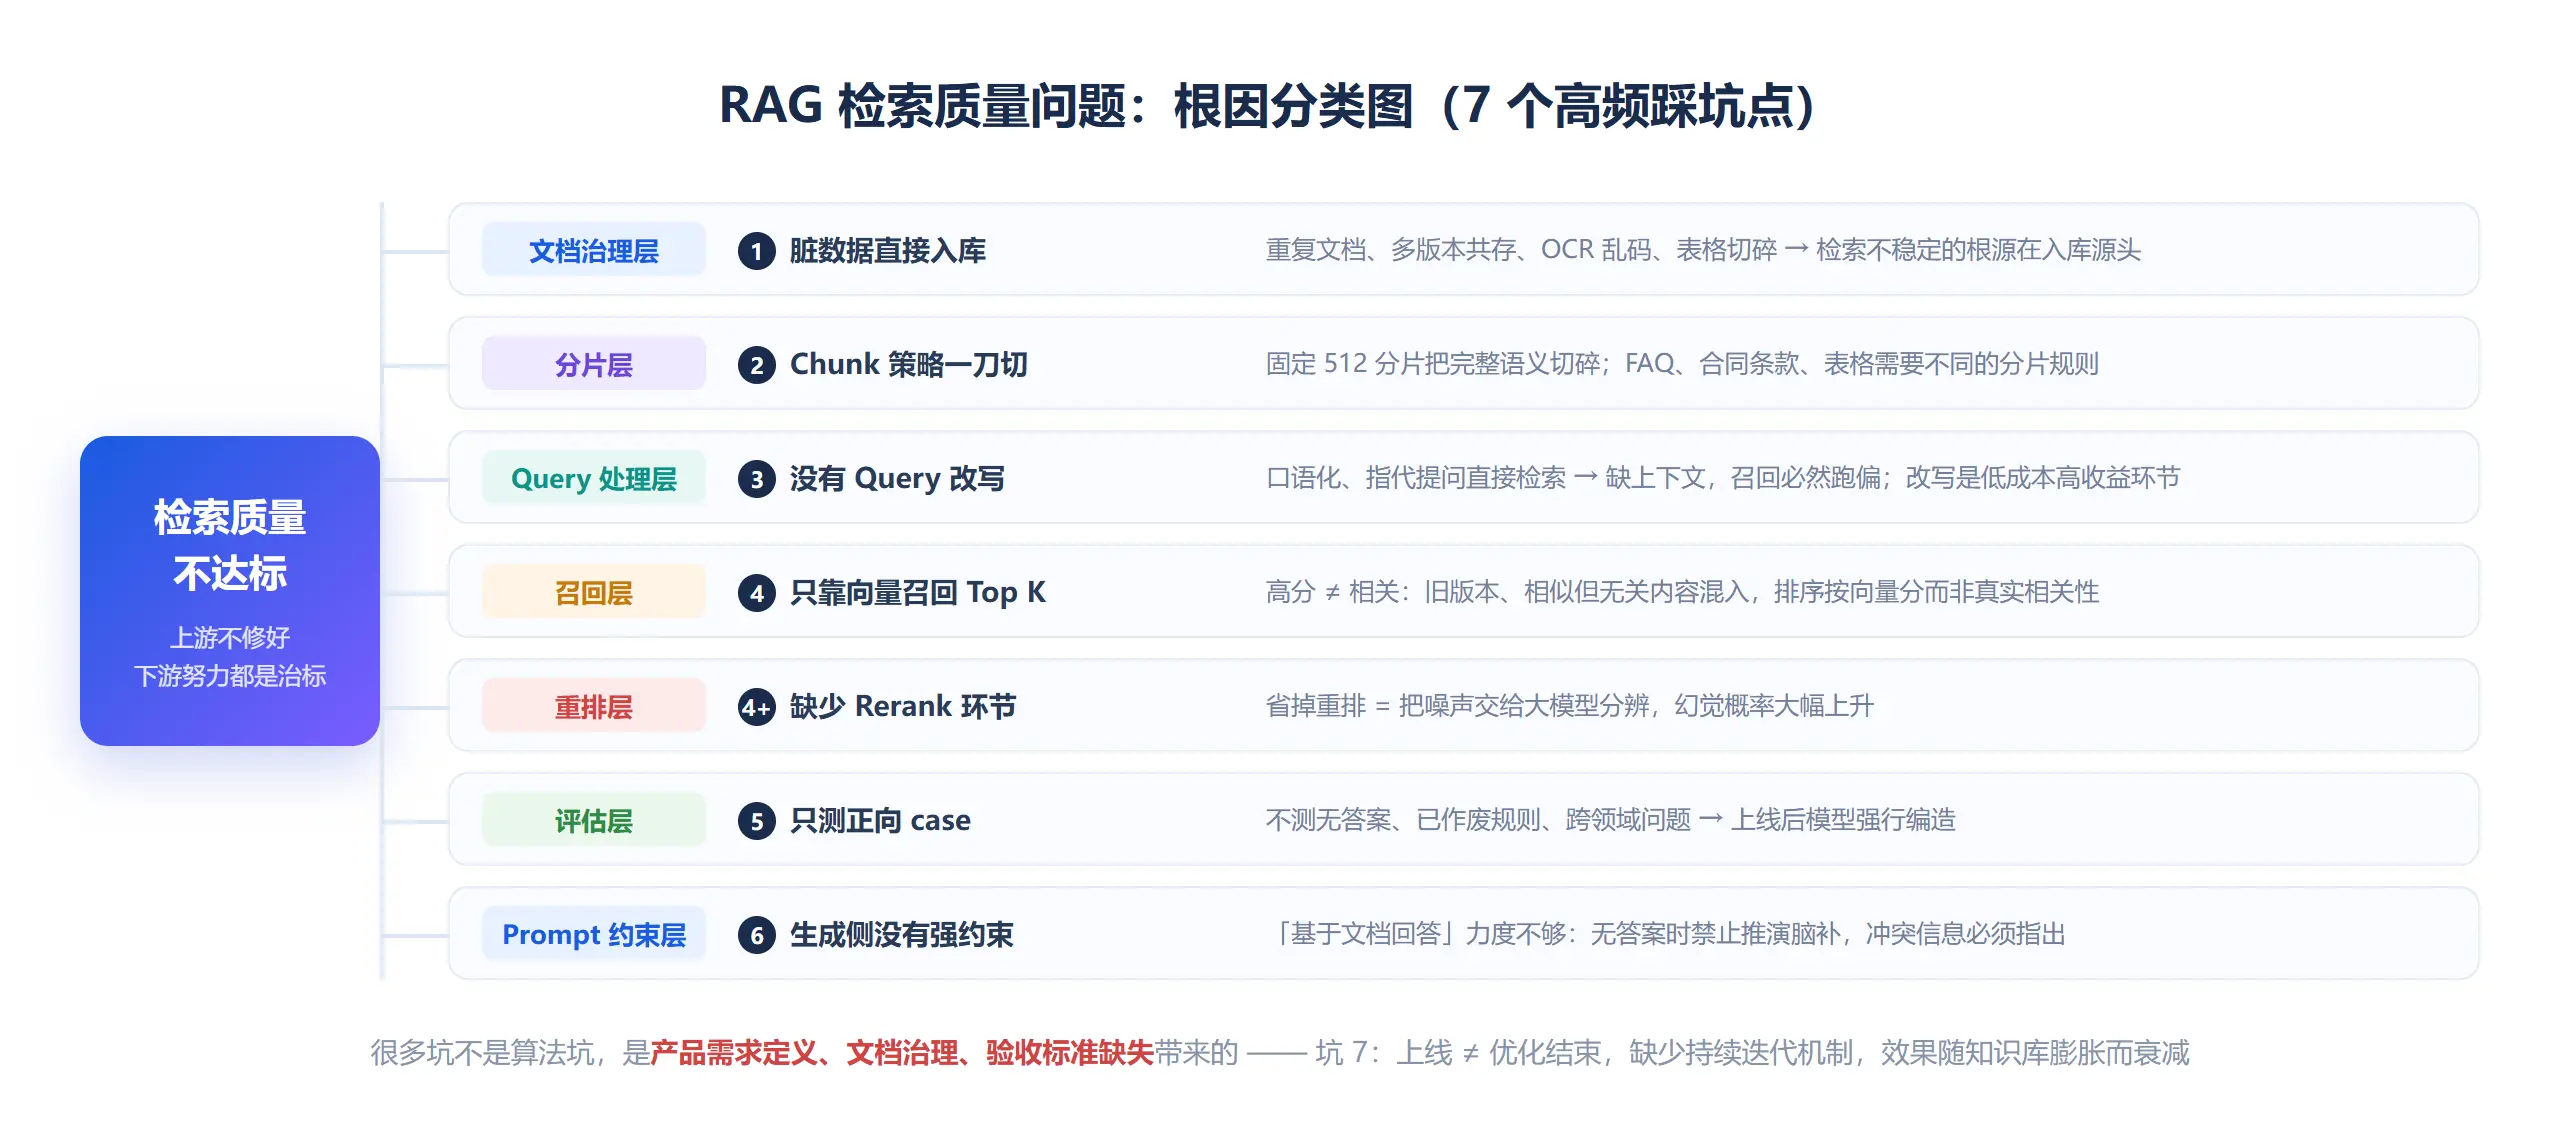
二、RAG 检索全链路,7 个高频踩坑点(商品最容易忽略)
我按从上游到下游的顺序整理。很多坑不是算法坑,是新品需求定义、文档治理、验收标准缺GA带来的。
坑 1:文档入库前不做治理,脏数据直接灌入向量库
很多队伍拿到一堆文档直接切片入库:重复文档、多版本共存、扫描件 OCR 乱码、附件截图无文字、表格被切碎、页眉页脚冗余信息。检索不稳定的根源,往往在入库源头。
新品要先定义文档准入规范:哪些文档是有效源、旧版本怎么标记Eliminated、表格怎么拆、冗余News怎么清洗。不是所有文档,都适合放GF知识库。
坑 2:Chunk 分片策略一刀切,固定长度分片
网上教程最喜欢说 chunk 512、overlap 100。真实业务里,合同、流程制度、工艺方案、FAQ,适合的分片规则完全不一样:
- FAQ:短文本,小分片更合适;
- 合同topics款:不能把一topics完整topics款拦腰切断;
- 数据表格:强行截断会丢GA行列关联关系。
固定分片尺寸,会把完整语义切碎,检索拿到残缺片段。
坑 3:没有 Query 改写模块,直接拿原始客户议题去检索
使用者提问五花八门:口语化、省略主语、指代提问、多问题合并。
例:上文聊了合同有效期,使用者接着问”那最晚什么时候Submit?”——直接拿这句话检索,缺少上下文,召回结果必然跑偏。
Query 改写的方向:补全指代、拆分多状况、改写为适合检索的标准问句,是检索上游非常低成本、收益极高的环节。
坑 4:召回Sort只看向量分,缺少重排(Rerank)环节
这个坑其实覆盖了召回和重排两层问题:
- 召回层: 向量返回 Top5、Top10,Sort是按向量分,不是按”和问题相关性”Sort,高分片段里混杂着相似但无关News;
- 重排层: 重排模型的作用就是二次打分,优先保留真正包含答案的片段,过滤掉语义相似但无关的噪声。
很多班底省掉重排,看似省开销,本质是把噪声交给大模型去分辨,幻觉概率大幅上升。
坑 5:检索评估只做正向 case,不做Loss向 case 测试
测试的时候,大家习惯性拿自己知道答案的问题去试,效果看着很好。但是很少去测:不存在答案的议题、问已作废规则、跨领域无关问题。
缺少Loss向样本测试,上线后遇到知识库没有答案的问题,模型强行编造内容。
坑 6:检索结果没有溯源边界控制,Prompt 没有强约束
哪怕检索到正确片段,如果 Prompt 写得太松,模型依然会脱离原文自由发挥。很多 Prompt 只写”基于文档回答问题”,约束力度不够。
合规类、机构制度类问答,必须严格限制:找不到答案就如实说不知道,禁止推演、禁止脑补。
坑 7:没有持续迭代机制,检索效果是一次性验收
文档持续新增、业务规则持续更新,Embedding、检索权重、重排阈值都需要持续调优。很多项目上线等于优化结束,没有定期抽样评估检索集,随着知识库膨胀,成效慢慢衰减。
三、核心干货:一套可复用的检索做工评估清单
重点来了:怎么判断检索好不好?不靠感觉,靠标准化打分。这套清单,我在好几个内部 RAG 项目用来做验收、版本比较,产品、算法、测试可以对齐标准。
评估方式: 抽样一批测试问句(建议总量不少于 50 topics,其中Loss向 case——无答案、已作废、跨领域——占比不低于 20%,指代与歧义 case 占比不低于 20%),每topics问题对检索召回结果打分,满分 10 分。
✅ 检索品质评估打分项(公开样例版)
- 相关性(3 分):召回片段是否和用户议题Topics相关,无大量无关噪声
- 信息完备性(2 分):答案需要的关键信息,是否All包含在召回片段内,没有缺项
- 正确性(2 分):召回的是Newest有效版本,没有召回作废、过期、冲突文档
- 无冗余(1 分):没有大量重复信息,不占用上下文窗口
- 可区分性(1 分):知识库无答案时,不会强行召回近似但错误内容
- Sort合理性(1 分):最相关、包含答案的片段排在靠前位置
打分参考:
- 9~10 分:检索优良,稳定拿到正确完整素材;
- 7~8 分:合格,少量瑕疵,配合 Prompt 约束可以稳定回答;
- <7 分:检索不合格,优先优化检索链路,不要去调生成 Prompt。
配套记录字段(清单里):状况原文、Query 改写后、召回文档列表、每段摘要、打分、状况类型、缺陷备注、优化方向。
产品重要提醒: 只要检索打分长期低于 7 分,不要在生成侧死磕 Prompt。检索是瓶颈,上游不修好,下游努力都是治标。

四、配套:分层 Prompt 库外观(适配 RAG 不同环节)
很多人把所有逻辑塞GF一个 Prompt,耦合严重,不好迭代。我习惯拆成 4 类 Prompt,各司其职,按需启用:
1. Query 改写 Prompt(检索上游)
Generate poster / share QR code
