



































WorkBuddy本地部署超强OCR识别小模型
建筑图纸里的文字表格总提取不准,难题常常不在Prompts,而在模型选型。这篇区分OCR专用模型与多模态模型的边界,用一段Prompts把MiniCPM-OCR部署到本地,再拿25页施工图纸实测识别成效。
Today来填个坑的,之前老马写过一篇建筑行业怎么使用WorkBuddy来GF行AI办公提高效率的文章。有位从业老哥留言,说Me法子行不通,瞬间就有点丈二和尚摸不着头脑。
他说自己做了几个Skill,发现WorkBuddy对于建筑施工方案,估计应该是图纸类的,提取信息的效果很差,而且存在不准确的情况。
假设建筑施工方案图纸是PDF格式的文件,或者是PNG和JPG的扫描截图也行,不是专业的DWG和DXF文件。那么提取里面的文字、Photos、表格等信息,就取决于你用的是什么模型。
OCR模型与多模态模型各管一摊
一般来说分为专业的OCR识别模型和多模态模型,两者各有千秋。OCR模型是高精度的看图识字,对于复杂排版,密集多栏,倾斜标注或者手写字体等情况下的文字识别很稳定,极少会出现幻觉。
二多模态模型就是我们常用的大Language模型,它的亮点在于对图纸GF行语义理解和空间推理,比如能够对三维空间GF行感知推理,能根据剖面图推算出楼层净高,识别出转角窗户,把工程语义与上下文关联等。
所以我们如果只是想要提取建筑施工方案图纸里面的精确的各种文字和数字信息,那最好就是使用OCR模型。如果是要GF行图纸的语义理解,合规审查和冲突检测,那就使用多模态的大Language模型。
因此老马判断下来,这位老哥应该是第一种需求。而使用OCR模型的需求,不只是在建筑行业。日常我们工作生活中需要对一些文件的扫描件,手写件,学生的试卷,老旧破损的书籍报纸等GF行识别提取。
甚至说是还原和修复,像有些模糊不清的图像和照片上的文字内容,都可以借助OCR模型来提取,这不就达到了还原修复的成效了么。所以我们使用WorkBuddy在本地电脑部署个OCR模型,有备无患。
小钢炮MiniCPM-OCR 1.0
正好国产模型厂商面壁智能化前几天刚开源了一个迷你的小钢炮OCR模型:MiniCPM-OCR 1.0,老马实测体验下来相当哇撒。之所以是小钢炮,一是面壁智能化近段时段都在着力端侧模型的研发。
因此模型往小了做,但能力却没差多少,端侧模型毕竟都是要装在车机,智能机型,AI智慧硬件等这类硬件资源不是太强的设备上的。而MiniCPM-OCR 1.0就是这样的小而强的模型,老马16G内存的Mac笔记本都能轻松跑起来。
反观差不多Time开源的百度文心Unlimited OCR 2模型,本地部署需要A100或H100级别的显卡,消费级甜品卡推理不起来。这就跟普通使用者没多大关系了,除非是土豪。
而普通的家用电脑只要内存足够,CPU不是太老太差的,都能部署MiniCPM-OCR 1.0到本地运行起来。大不了是识别的速度快慢的状况,硬件配置低的识别等待Time长一些,重点是完全不需要你有消费级的独立显卡。
其次,如果你不想在本地电脑部署,也可以使用面壁智能的官网去Online上传文件GF行识别,那速度也是贼快的。只需要注册个账号,还送Pts额度,直接Online使用即可:
platform.modelbest.cn/console/playground/document-parse
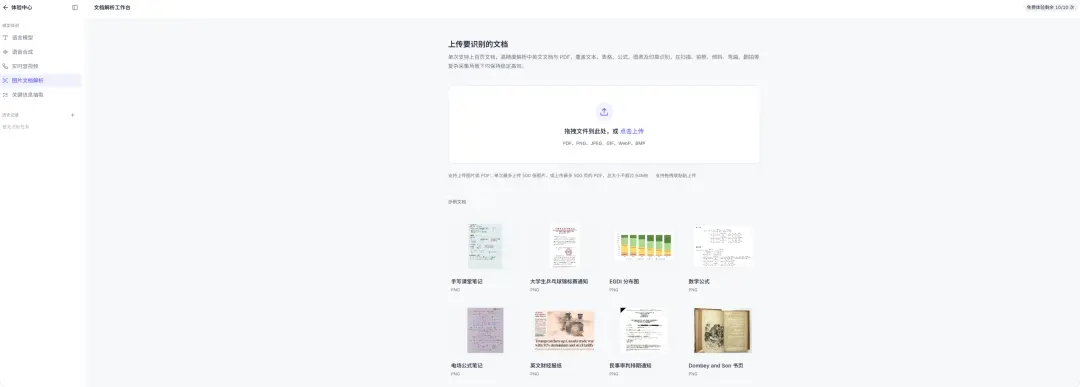
当然这个OCR模型也是兼容API调用的,只不过需要充值额度罢了。下面老马就直接演示如何让WorkBuddy帮我们本地部署这个超强的MiniCPM-OCR 1.0 OCR模型。
本地部署:一段Prompts搞定
途径很简单,直接把下面的这段Prompts发给WorkBuddy就行了。如果提示访问不了github,你就先让WorkBuddy解决网络访问的状况。老马不再给大家值得一试方式了,Previous文章已经被WeChatDelete:
Prompts模板
阅读理解并安装这个项目 github.com/OpenBMB/MiniCPM-OCR/blob/main/docs/SKILL_en.md
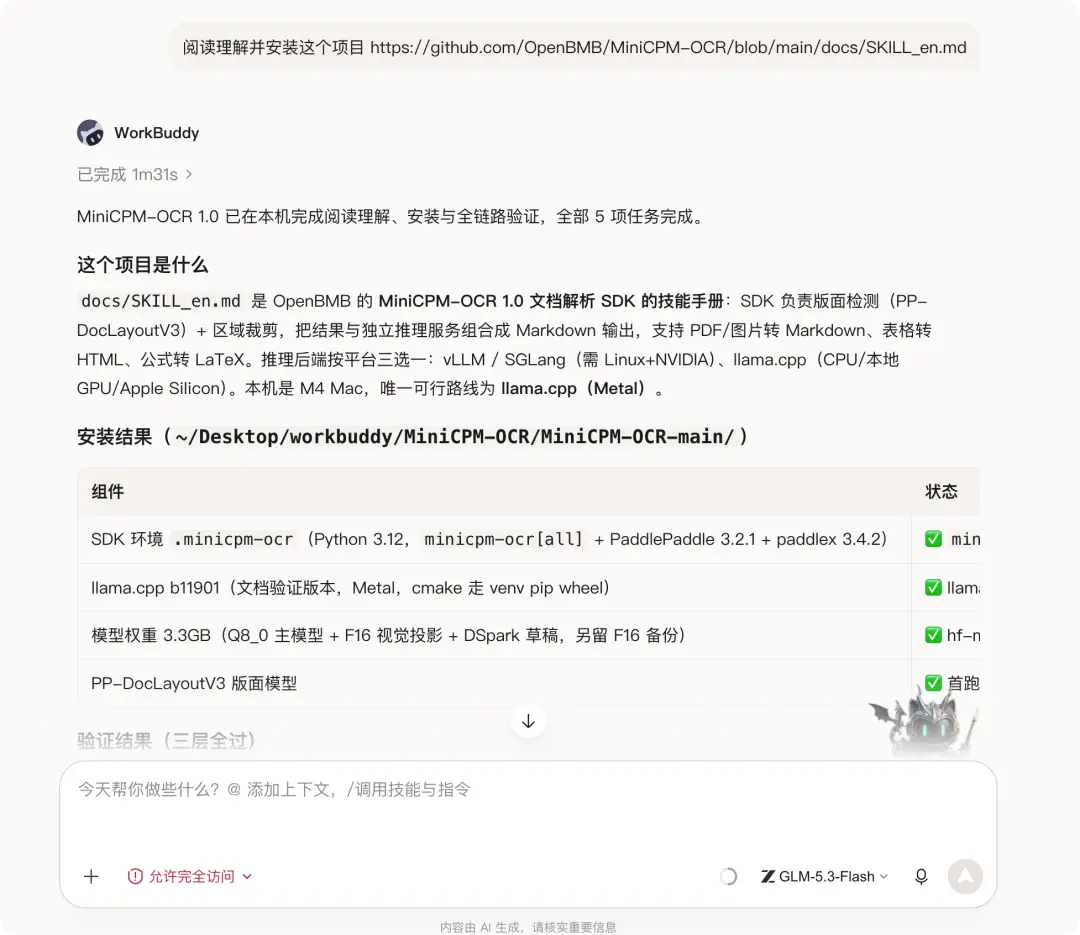
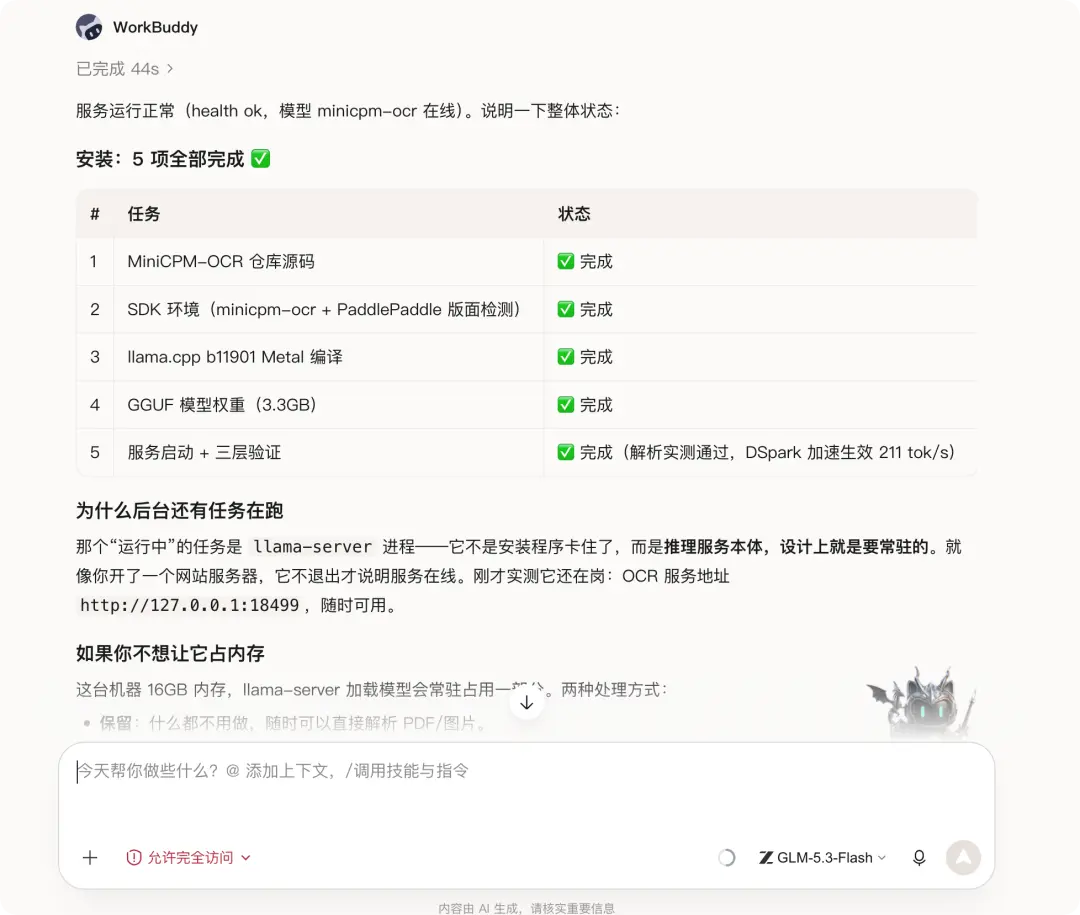
安装项目时会去Download模型的本地权重文件,大概3.3G的大小。还有SDK环境和llama.cpp的推理环境,你看不懂没关系,All让WorkBuddy去验证是否安装完成,是否可以正常跑起来:
搓个网页用OCR
这里有一个细节,本地部署完毕推理跑起来后,像有些llama.cpp的版本是没有提供网页界面的,只提供推理的API。因此你想使用这个OCR的识别业务,就得使用命令行,或者开发个别的程序啥的去调用API。
虽然网上也有很多的开源项目可以调用API去使用,就是一个壳子,但我们没必要搞那么复杂。直接让WorkBuddy研发一个网页,这个网页Features很简单,就是可以上传文件,然后调用本地推理API去实现OCR识别:

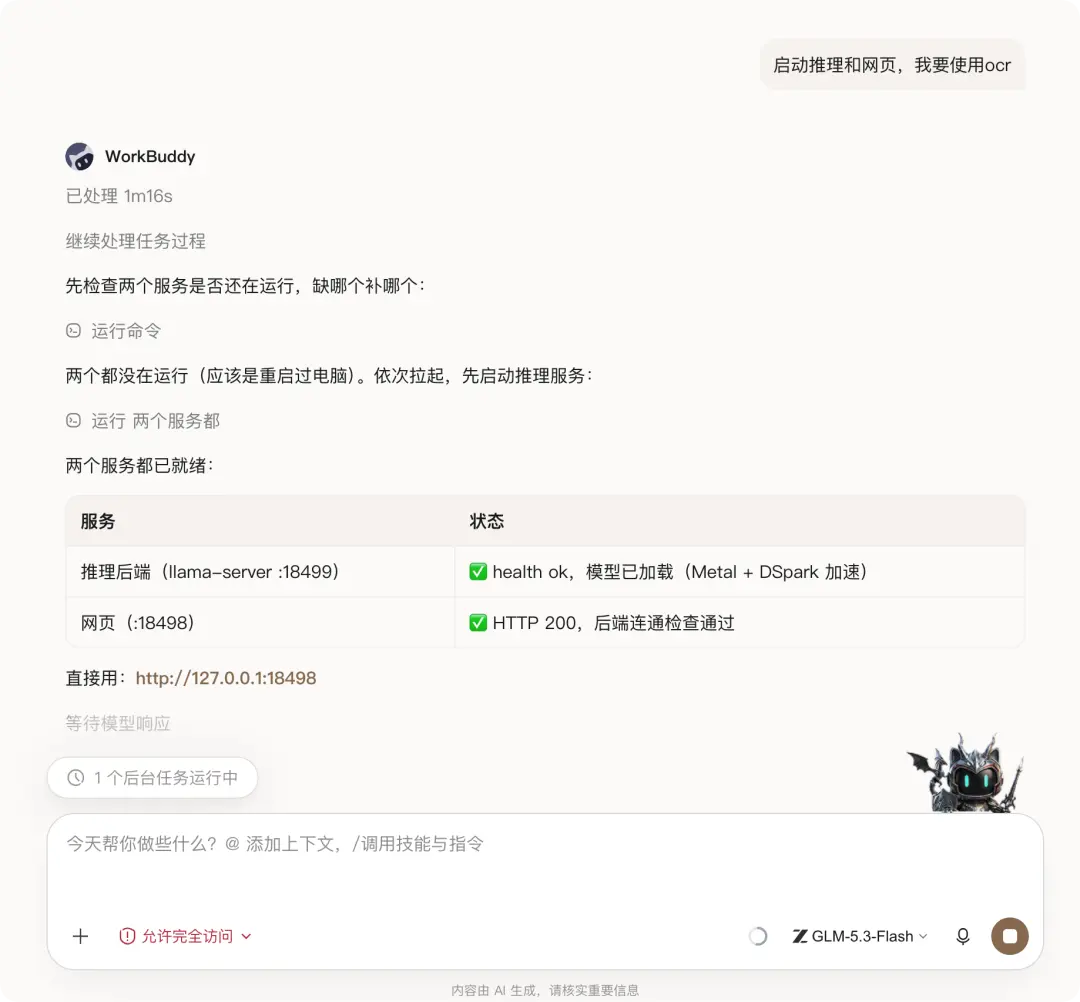
如上图所示,WorkBuddy就已经帮老马打造完这个网页入口了,以后想用OCR识别啥文件,直接让WorkBuddy启动本地推理业务,以及网页业务,一般这两个后台业务启动起来,就可以正常打开网页使用OCR了:
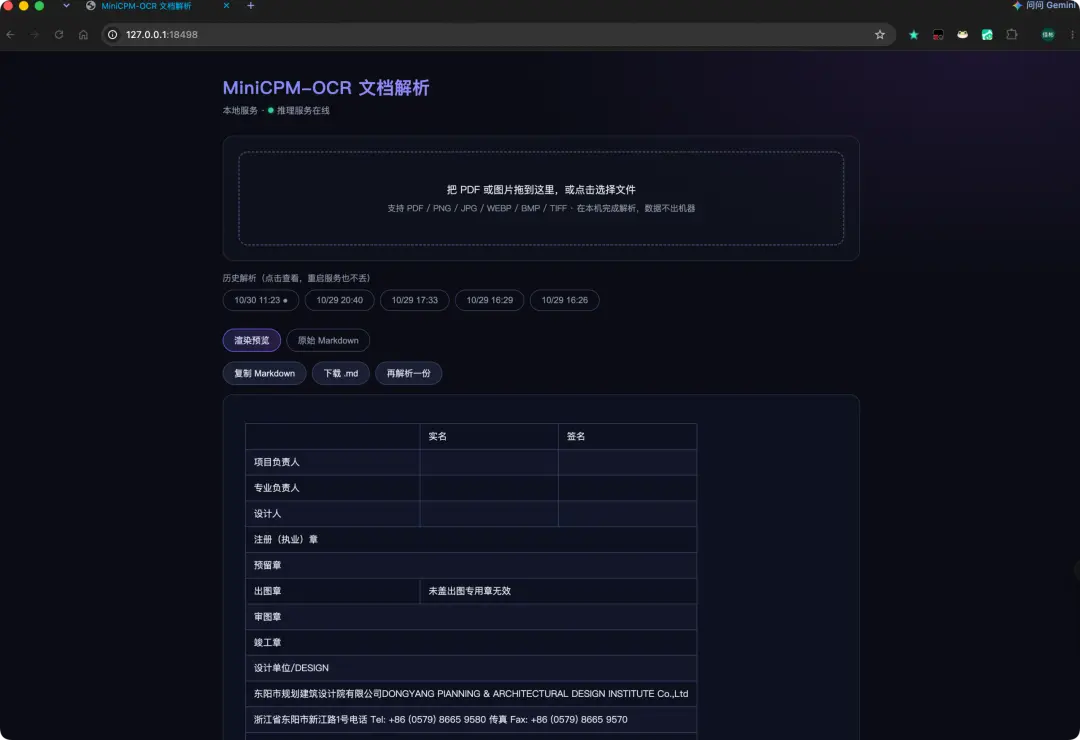
在启动服务支持的过程中如果遇到网页打不开的情况,可以继续让WorkBuddy去检查后台服务,因为有时候你电脑上的Others软件或者服务支持可能会占用掉网页的端口之类的。老马的网页版MiniCPM-OCR 1.0启动后如图:
实测:25页施工图纸识别
这里老马是上传了一份群友提供的文体中心建筑施工方案图纸,纯PDF文件有25页,里面的所有文字都能识别出来,也就不给大家截图展示成效了。主要是展示一下里面的一些图纸的识别效果:

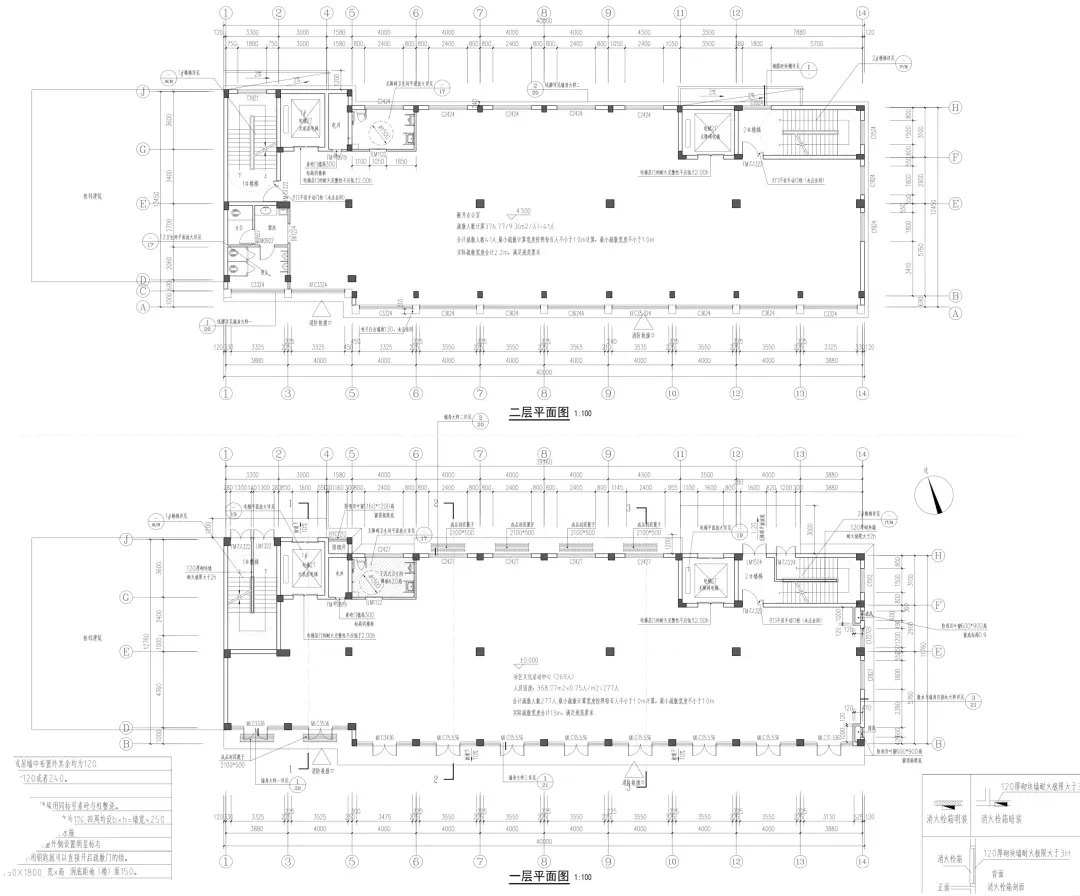
像上面的这些图纸识别出来是高清照片,可以放大GF行查看,里面的每个文字每topics线topics都是清清楚楚的,更不用说文字和符号了。如果要GF一步对这些高清PhotosGF行文字提取,那就重新上传再OCR识别一下。
还是那句话,如果你对这个MiniCPM-OCR 1.0模型的能力还不信任,可以先用前面老马提供的官网Online使用感受地址,去感受一下,再考虑要不要本地部署的状况。反正对于老马来说,这个成效已经是相当不错了。
作者:马佳彬 公众号:马佳彬
本文由 @马佳彬 原创Post于人人都是产品经理。未经作者许可,禁止转载
题图来自 Unsplash,基于CC0协议
Generate poster / share QR code
