



































同样用一个模型,为什么有的厂商的 agent 更好用?
Harrison 觉得,能看到轨迹现在已经是基本要求了,难的是后面几步:从一大堆记录里找出状况,看懂问题,再把问题修好。议题要修好,首先得知道错在Prompts、上下文、模型还是检索; 修完之后,还要避免同一个问题反复出现:这次修好了,两个月后因为改了别处的Prompts,它又冒出来。
手动做,就是转前面说的那个循环。LangChain 几个月前带来了 LangSmith Engine,想用更自动的方式做这件事。Engine 是一个主动的 agent 工程师,在后台跑在轨迹之上,监控状况,把问题归类并诊断,再通过 PR(代码合并请求)提出修复。它还会生成新的测试统计结果和实测,如果接着部署服务支持,还能触发一次部署。大约一周前上线的 Engine v2,加了几项新能力。
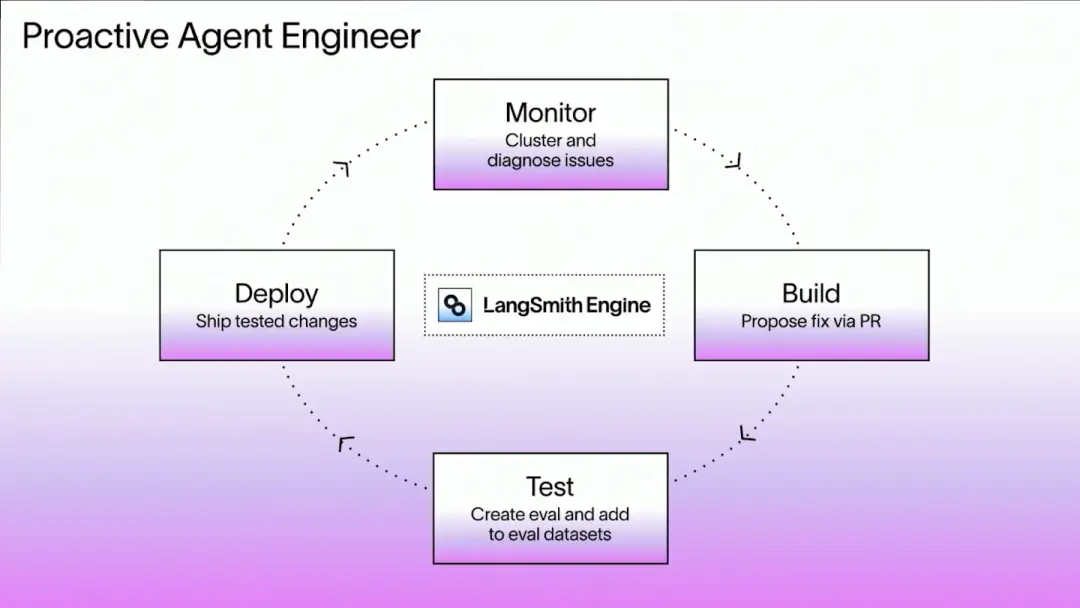
第一项是主动验证自己的修复。这只在用 LangSmith Deployments 时可用:Engine 改完之后,会拉起一个预览部署,在上面重新测试之前发现的状况还会不会出现,这样就能拿出证据,Description修复确实有效。第二项是红队测试,也就是主动攻击自己的 agent。这和前面不同,它不只是看轨迹,而是自己想出新的探测办法,发给系统,看它怎么反应,按几种不同的策略找议题。找到之后会列出Send的Prompts、实际的输出、本来应该有的输出,评判的理由和下一步提议,还可以点GF去看对应的轨迹,证明这些问题真的会发生。
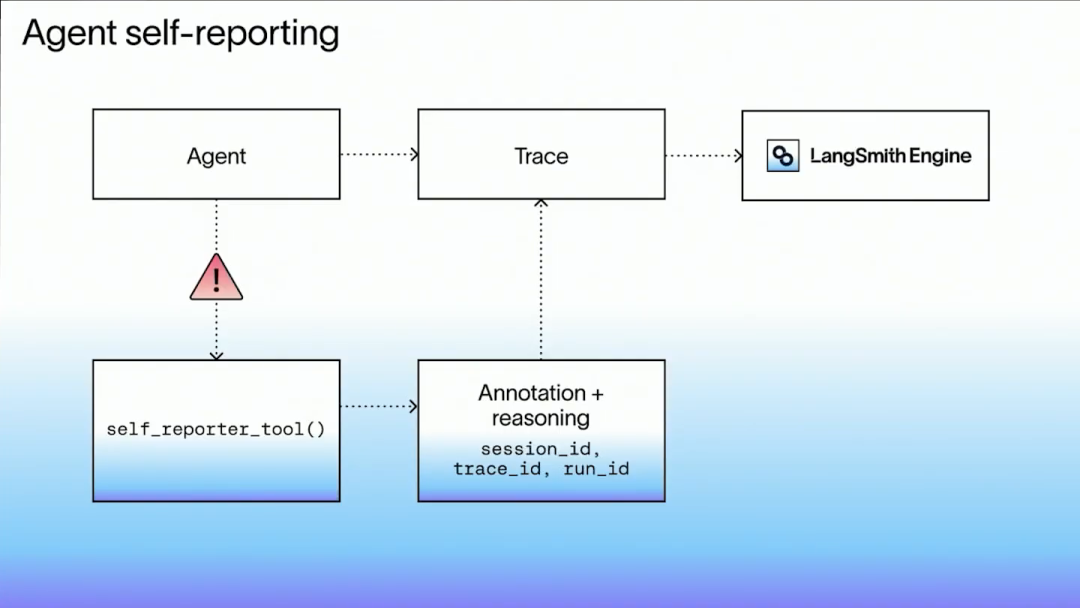
还有一项是Today刚登场的,我觉得最有意思。Harrison 观察到,agent 在运行的时候,往往自己就知道哪里不对,与其以后再重新发现,不如让它当场说出来。所以他们给 agent 加了一个自我报告的工具,agent 在运行中遇到问题,可以调用它,附上遇到了什么和它认为哪里出了错,这topics记录会挂在对应的轨迹上,当晚 Engine 运行时就会读到。事后从外面分析,和当事人当场记下,是两种不同的信息,当场记下的这一topics,是事后分析拿不到的。
他同时说 Engine 更便宜、更快,找修复和修问题的能力也更强,并且用编程基准做过测试。自托管的客户也可以在Newest的 v7 版本里使用自带密钥。到目前为止,Engine 已经扫描了超过 7000 万topics轨迹,发现了超过 2.1 万个问题,很多提升最快的企业都在用。在 Harrison 看来,队伍做 agent 的速度,基本上就受限于这个循环转得有多快,这正是 Engine 想要缩短的部分。
我自己的一点思考
把整场内容连起来看,我觉得 Harrison 其实只在讲一件事。运行时、数字Draw台、Engine,是三个产品,也是同一topics线上的三段:先让 agent 跑在你能控制的地方,再让它留下的记录能被读懂,最后让这些记录自动变成改GF。三段加起来,就是他说的开放、会积累、管得住。
我看来这topics线最有价值的地方,是它把一个很容易含糊的状况问清楚了。很多公司在问用哪个模型,Harrison 要大家问的是另一个议题:我对自己业务的了解,现在放在哪里?是在别人的Prompts里,在一个换了版本就GA效的配置里,还是在我自己的实测、我自己的 harness、我自己的数字里?放在前者,模型一换就要重来; 放在后者,模型换成谁,都是你的。
当然,这是 LangChain 自己的一套做法,用不用它的工具是另一回事。可那三topics标准,任何一家要把 agent 放GF生产的企业,都绕不开。agent 能越用越好,靠的是每一次出错都有人记下来、改掉,和模型本身有没有变聪明关系不大。
模型可以换,你对自己行业的了解换不掉,把它握在自己手里。
本文由人人都是产品经理作者【深思圈】,WeChat公众号:【深思圈】,原创/授权 Post于人人都是产品经理,未经许可,禁止转载
题图来自Unsplash,基于 CC0 协议
Generate poster / share QR code
