


































AI RAG 项目从 0 到 1 踩坑:大多数团队卡在检索质量,我整理了一套可直接复用的评估清单 + Prompt 库
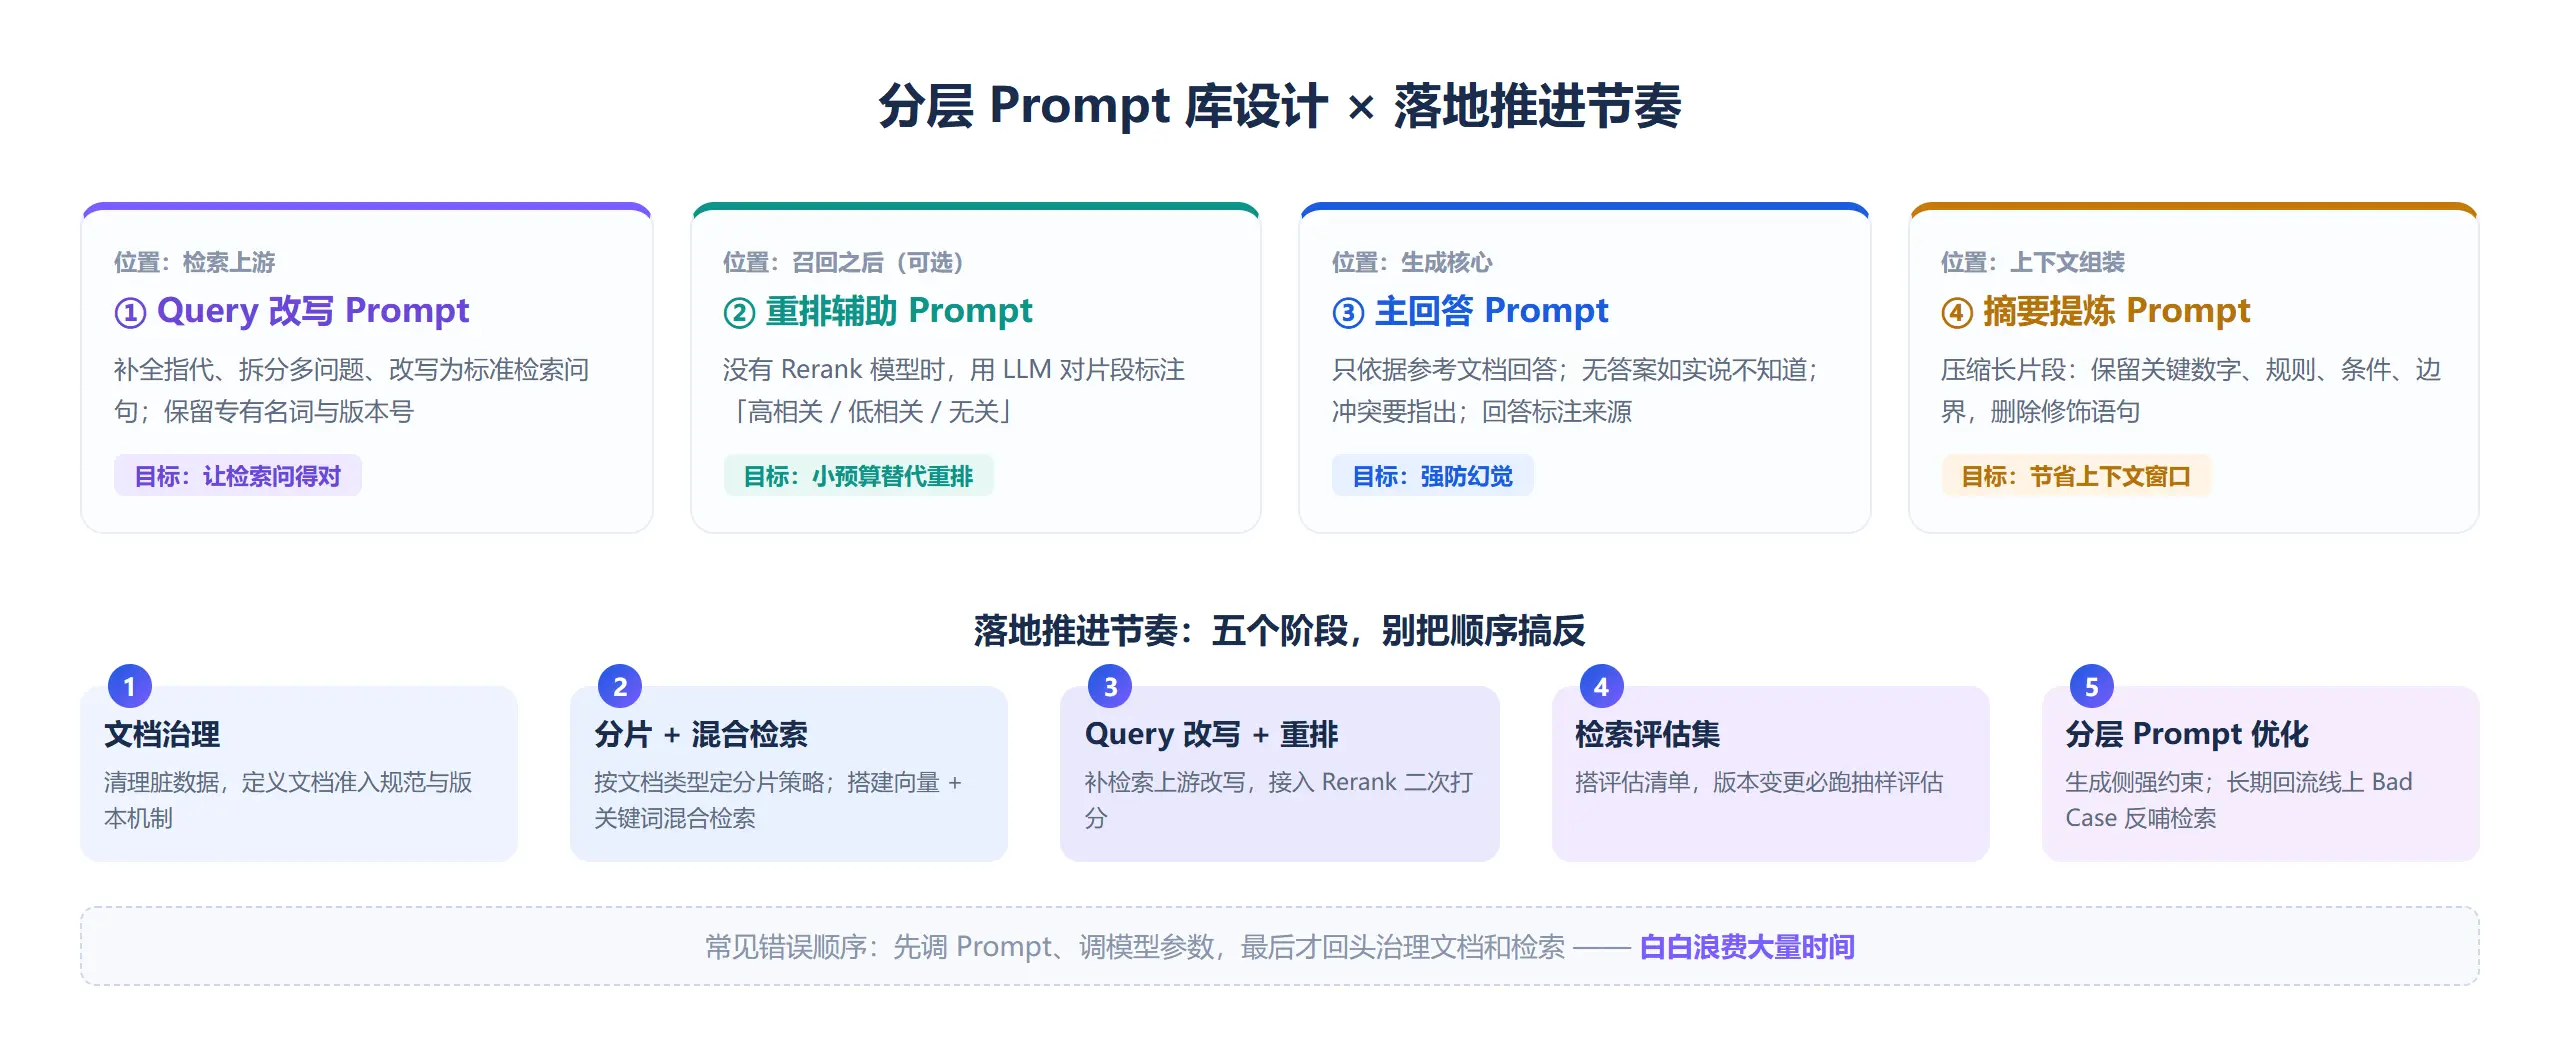
角色:你是查询改写专家,基于历史对话和当前用户问题,生成适合知识库检索的标准查询。 要求:
1. 补全指代、省略信息,消除歧义;
2. 如果使用者同时问多个议题,拆成独立检索问句;
3. 保留专有名词、编号、版本号等关键信息;
4. 不要额外回答使用者问题,只输出改写后的检索词/问句列表。
2. 检索后重排辅助 Prompt(可选,小预算没有 Rerank 模型时用)
给定用户问题和下面多条文档片段,请判断每一条片段和难题的相关性,只输出【高相关 / 低相关 / 无关】,简短标注理由。
3. 主回答 Prompt(核心生成 Prompt,强防幻觉)
你是企业知识库问答助手,只能严格依据【参考文档】里提供的信息回答用户难题。
规则:
① 如果参考文档中没有对应答案、信息不足、互相冲突,直接回复:当前知识库暂无相关信息,无法解答;禁止猜测、推演、编造;
② 回答优先引用原文表述,不要自行引申出新规则;
③ 如果有多条冲突信息,需要指出文档冲突,不要自行选择一个结论;
④ 回答结尾标注信息来源(文档名称 + 章节/条款号);
⑤ 不要超出文档范围回答。
参考文档:{retrieve_context}
用户议题:{query}
4. 摘要提炼 Prompt(长片段压缩,节省上下文窗口)
对下面文档片段做精简摘要,保留关键数字、规则、条件、边界,删除修饰语句,不要丢失关键约束。
说明: 上面是基础版本,实际业务还会衍生:FAQ 专用 Prompt、合同解读 Prompt、工艺文档问答 Prompt 等,不同场景约束强度不一样。
五、落地推进节奏:产品怎么安排迭代优先级
给产品一份落地顺序,避免队伍眉毛胡子一把抓:
- 第一阶段:文档治理规范先行(新品 + 业务/运营):清理脏数字,定义文档版本机制;
- 第二阶段:分片策略 + 混合检索(算法 + 产品):不要一刀切;搭建向量 + 关键词混合检索;
- 第三阶段:Query 改写 + 重排(算法):补齐检索上游改写,接入 Rerank;
- 第四阶段:检索评估集(商品 + 测试主导,算法配合):每次版本变更,跑一遍抽样评估;
- 第五阶段:分层 Prompt 优化(新品 + 算法):做生成侧约束;
- 长期: 持续扩充测试 case,定期回流线上 Bad Case,反哺检索策略。
很多队伍顺序搞反了:先调 Prompt、调模型参数,最后才回头治理文档和检索,白白浪费大量时刻。
六、写在最后
RAG 不是一个可以开箱即用的工具,它是一套数据 + 检索 + 提示词的组合操作系统。
大模型的能力大家都很容易拿到,拉开项目效果差距的地方,恰恰是这种偏工程、偏细节、偏枯燥的检索做工管控。Demo 好看很简单,业务稳定可用很难。
判断一个 RAG 项目能不能上线,先放下生成效果,先看检索能不能稳定拿到正确的原文片段。检索过关,问题就解决大半。
本文由 @EVE的星球 原创发布于人人都是商品经理。未经作者许可,禁止转载
题图来自作者提供
本文由News整理发布,仅供参考。
