


































Codex产品分析:从写代码的助手,到别人商品里的一个零件
场景与痛点:重构、迁移、补测试这类任务动辄几小时,人在旁边盯着是浪费,不盯又怕跑偏。[3]
方案与能力:桌面端开多个线程并行,每个线程一个worktree;云端提供可复用环境,合上笔记本任务继续跑;进行中可以插话改方向。[2][3]
差异化:WorkBuddy把并行做成「自动任务+项目空间」,用户在同一个工作台上排队推进多份交付物;扣子把并行做成项目空间里的多Agent分工,一个项目里可以有调研、运营、传播几个Agent各自认领。Codex做的是第三种:隔离的git工作树加统一验收面板,优化目标不是「协同」而是「不互相污染」。[3][19][9]
不足:任务越长,中途的决策点越多,使用者要么频繁回来回答状况,要么接受它按自己的判断走——两种都不轻松。[40]
场景二:代码评审
场景与痛点:首轮评审平均要等几小时,等到时作者已经离开上下文,反馈常常变成返工。[38]
方案与能力:提供GitHub PR与GitLab MR,可浏览摘要、深入diff、就疑点追问;自动审查可在人不在时先跑一遍。[2]
顾客作用:Ramp的工程班底把Codex放进评审环,首轮反馈从数小时缩到数分钟,并称其已成为许多评审流程的必备环节。这是供应商口径,尚无第三方审计。[38]
不足:评审带宽只是从人转移到人机之间。当三分之一的PR都有Agent参与,真正的瓶颈变成「谁来审Agent的审查意见」。[32]
场景三:非工程角色的交付
场景与痛点:分析师、设计、财务要的是可交付的产物(看板、页面、模型),不是一段代码。[15]
方案与功能:6个角色插件打包62个应用与110个技能;Codex Sites生成可分享的交互页面,Annotations支持就地修改。[15]
客户意义:OpenAI称知识工作者已占用户约两成,增速是研发者的三倍以上,72%的人每周产出物。同样是供应商口径。[15]
不足:与ChatGPT Work的边界越来越模糊——两边共享额度、共享harness,客户很难说清自己买的是哪一个。[15][4]
2.4 四个关键取舍
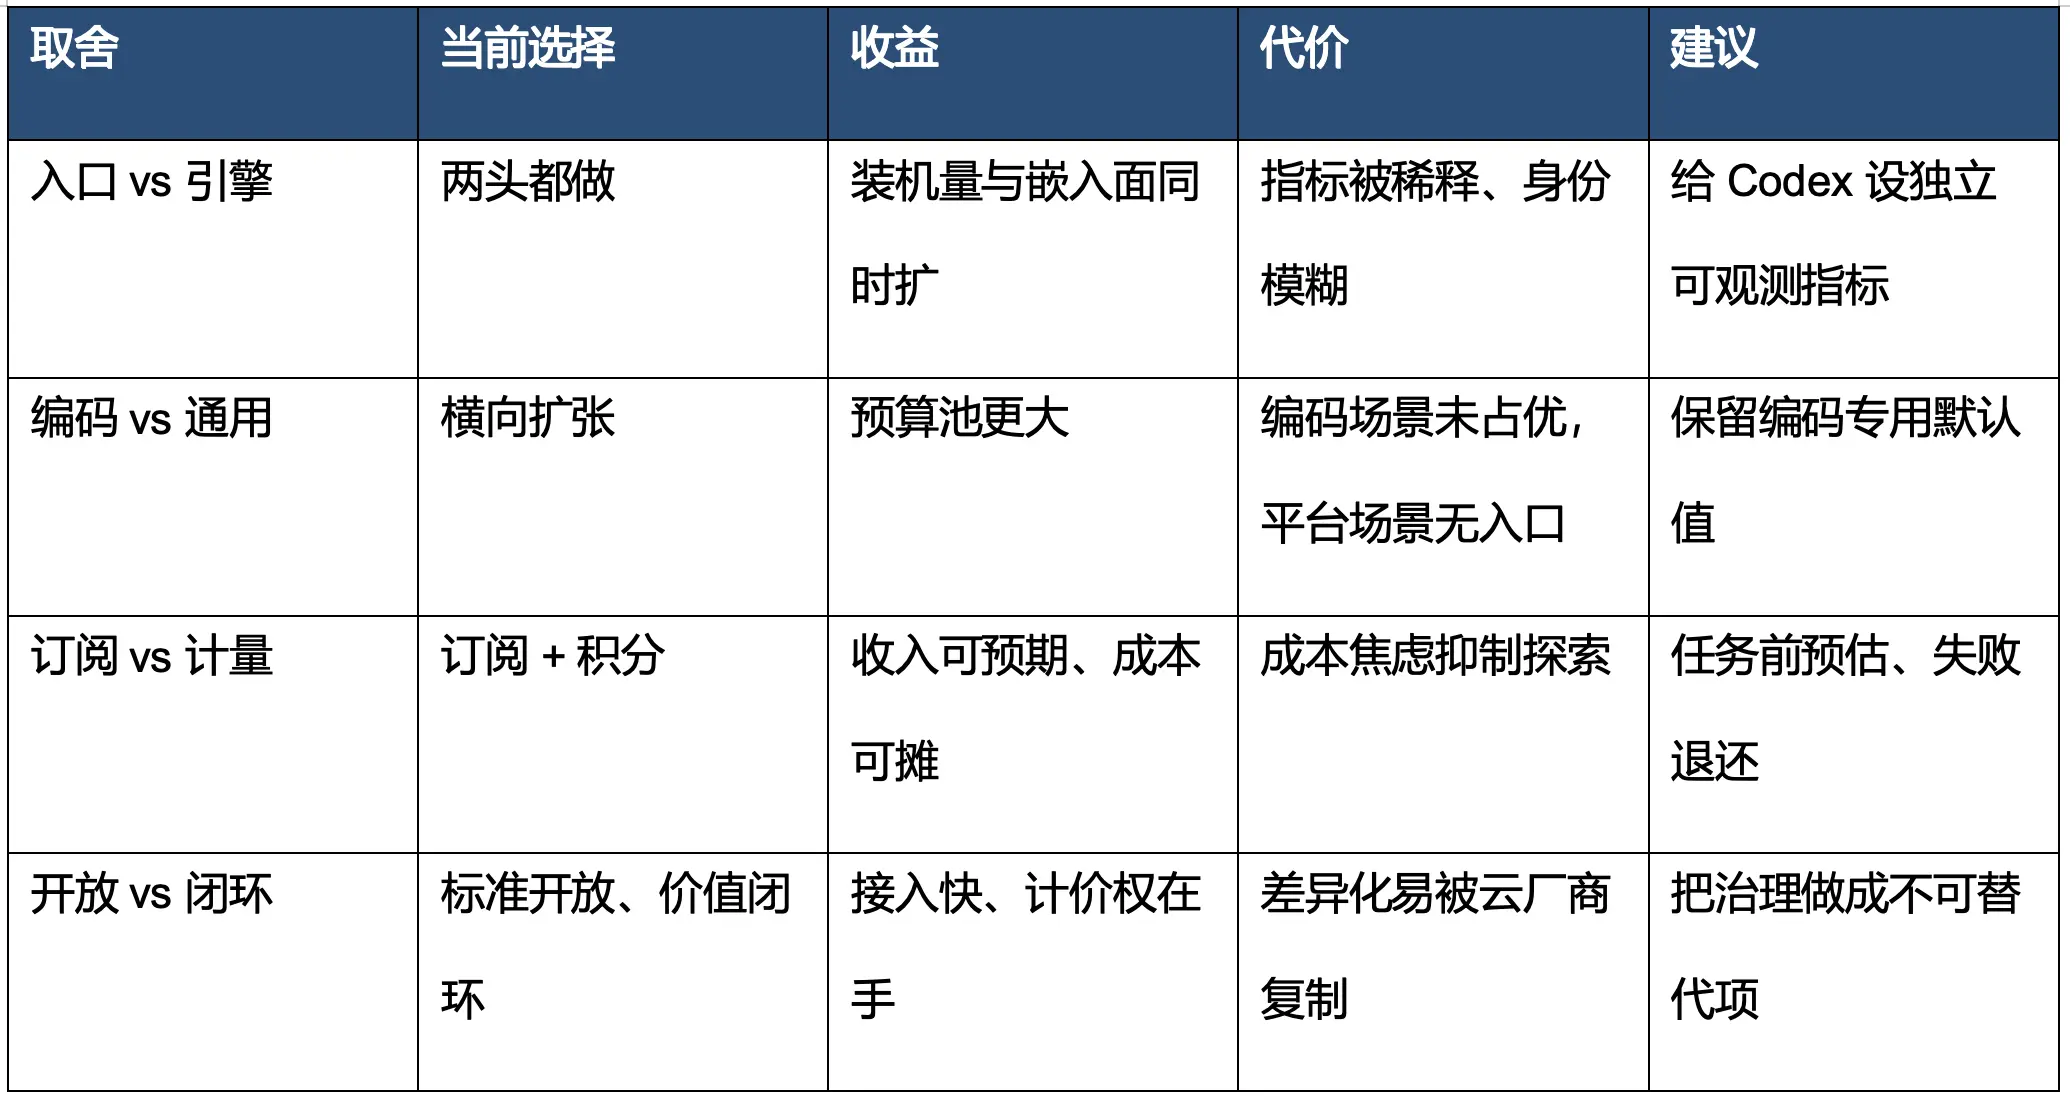
Codex今天的形态是一连串取舍的结果。对AI产品而言,取舍比功能更能解释成败,因为每一次取舍都锁定了后续的成本结构与攀升路径。[1][2]
取舍一:做入口,还是做引擎
2026年7月把独立Codex App并入ChatGPT桌面端,是一次明确的「做入口」的选择:借ChatGPT的装机量,把Codex从打造者工具变成所有人的侧栏。代价是身份被稀释——从此Codex的使用者数无法单独计量,商品指标被并进一个更大的池子。反过来,Harness开源又是「做引擎」的动作:让别的商品把Codex装进去。两条路同时走,短期两边都占,长期要在指标上付代价。[4][37]
取舍二:深耕编码,还是横向扩张
它选择了横向扩张。收益是天花板从「打造者席位」抬到「知识工作预算」,代价是每条新场景上都有一个已经在场的对手:办公交付物这条线站着WorkBuddy(3235.3万月活、绑死企微与腾讯文档),可亮相流程这条线站着扣子(1亿Agent、开源可自托管)。Codex在这两条线上既没有生态,也没有渠道,还缺本地化的合规资质。更现实的风险是:当一个新品同时服务支持工程师与分析师,它的默认值、评审标准、错误容忍度只能取交集,而交集的体验通常不如专用产品。[32][15][7][10]
取舍三:订阅,还是计量
它选择了「订阅+计量」的混合制:进门靠订阅,用量靠token。这在商业上最合理,在体验上最难受——用户永远不知道自己这一小时花了多少。Plus档每5小时15至160条资讯的区间,本质是把估算责任交给使用者;而OpenAI自己承认的研发者月成本是100至200美元,是20美元标价的5到10倍。[13][14][15]
取舍四:开放标准,还是闭环锁定
在标准层它选了开放:AGENTS.md是跨厂商的约定,MCP是公共协议,Harness也开了源。在意义层它保持闭环:模型、云端环境、额度池都留在自己手里。这个组合很聪明——开放降低接入阻力,闭环保住计价权。但它也意味着,一旦别家的模型在同一套标准上追平,Codex剩下的差异化只有执行面与治理,而这两样恰好是最容易被云厂商复制的东西。[1][37][31]
表5四个取舍的收益、代价与意见[1][2][4][32]
2.5 竞品对比:三个平台,九个维度
把三家放进同一张表,差异比单看任何一家都清楚:Codex赢在执行面与治理,WorkBuddy赢在交付物与生态分发,扣子赢在编排自由与发布渠道。三家的短板恰好是彼此的强项——Codex缺场景与渠道,WorkBuddy缺编排与开放,扣子缺执行深度。[32][7][18]
表6三个Agent平台的九维比较(2026年10月)[2][19][21][7][10][24][20]
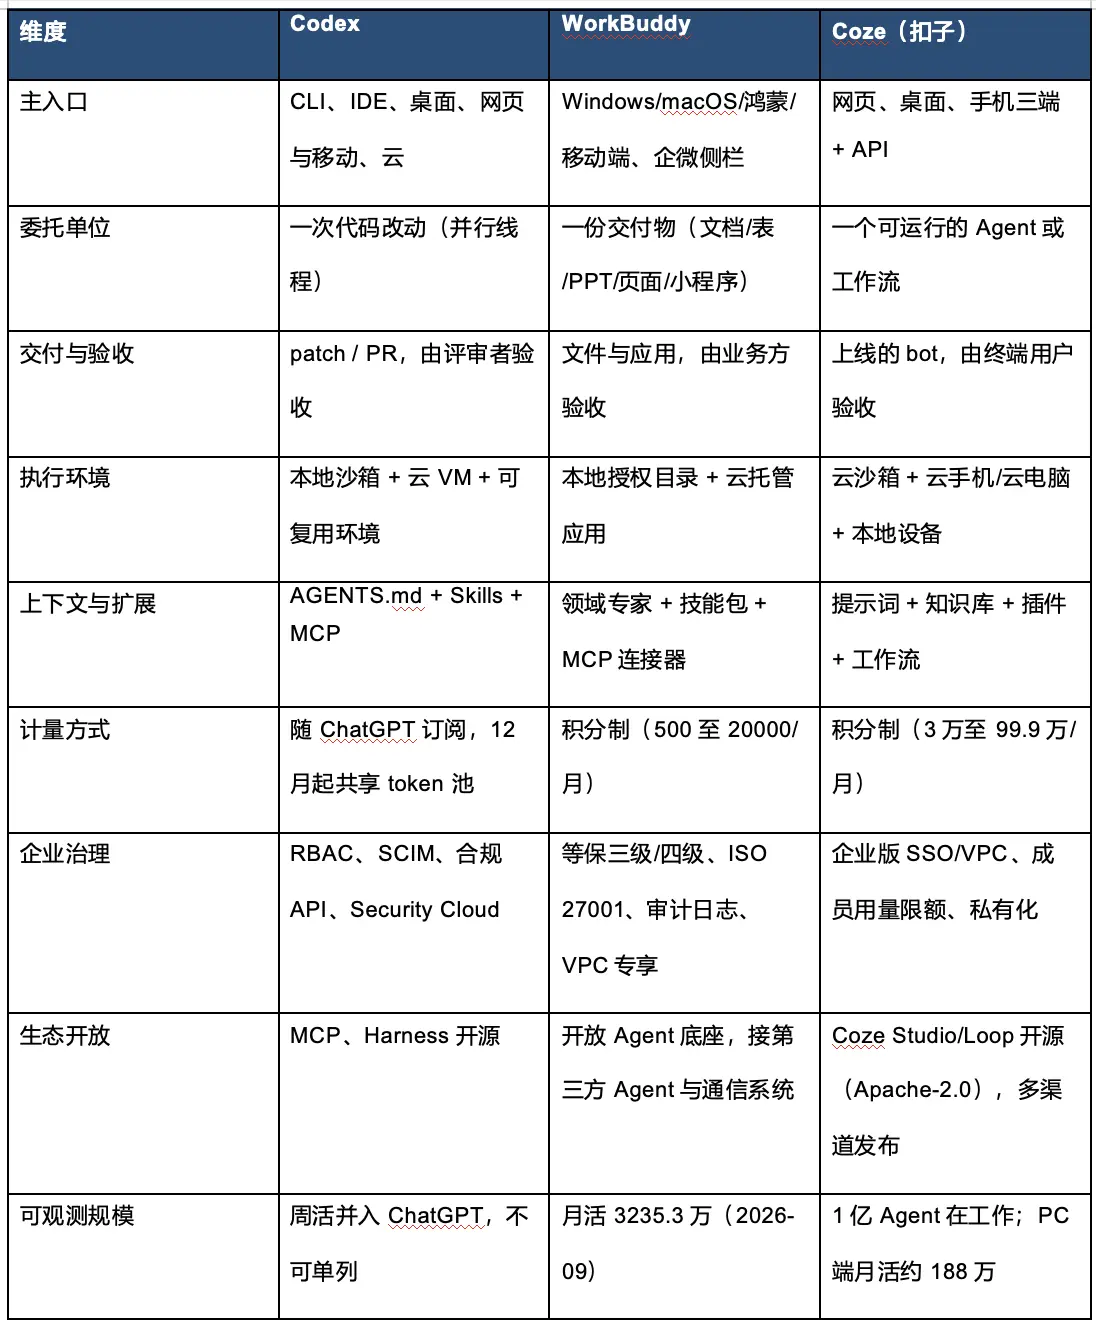
这张表里最容易被跳过的是「交付与验收」这一行,它其实决定了力气花在哪:Codex花在diff的可读性上,WorkBuddy花在成品文件的版式与可编辑性上,扣子花在发布之后还能不能继续调。三家都在做「让Agent干活」,但验收方不同,能力优先级就完全不同——这也是把三者放进一张表最有意义的地方:不是比谁强,是比谁在对谁负责。[3][19][9]
2.6 商业化与单位经济
Codex没有独立定价,它随ChatGPT方案走。这套设计的好处是获客开销极低——不需要单独说服财务;坏处是价格信号被彻底模糊,使用者买的是「一个额度池」,池子里还有ChatGPT Work在喝水。[13][14]
11月1日的公告把这件事推到了下一层:从12月起,Plus、Pro、Business三档的ChatGPT与Codex用量合并成一个池子,统一按token计量,Instant聊天不占额度,合并后的剩余额度与重置时刻在「设置 → 用量」里查看,用完了可以等重置、升级或买credits。官方给的理由是把Work的智能体能力并入ChatGPT主体验,实际效果是把「Codex值多少钱」这个难题彻底藏了起来——同一份额度既买聊天也买写代码,任何单产品的单位经济都无从计算。各档共享池有多少token、12月具体哪天开始,公告都没有给。[11][12]
表7 Codex的套餐与额度(2026年10月口径;12月起三档付费套餐改为与ChatGPT共享token池)[13][14][11]
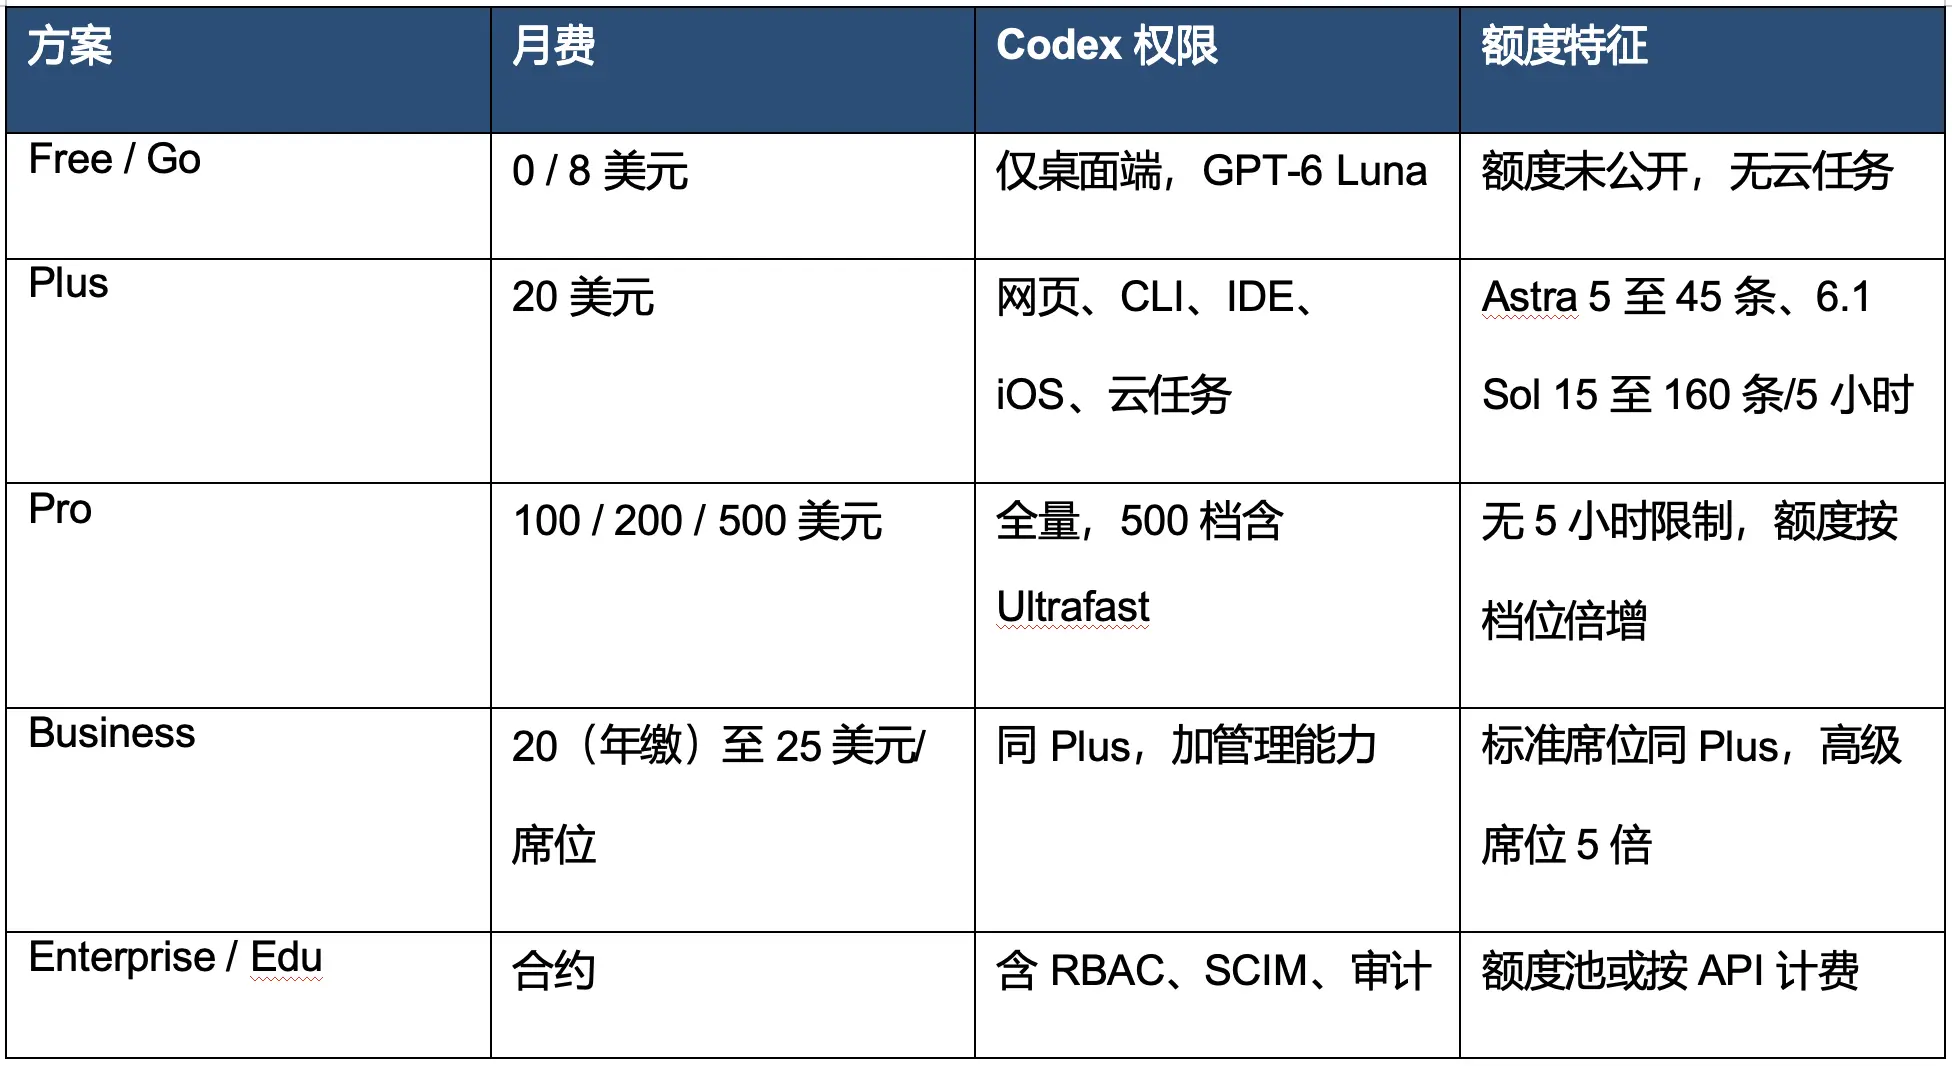
超额之后是积分:每积分0.04美元,2500积分合100美元。Fast模式消耗额度2.5倍,Ultrafast消耗8倍、积分6倍。这套换算的意图很清楚——把「快」变成明码标价的商品。问题在于用户很难预估一次任务要花多少积分,于是理性选择变成「少试几次」,而探索恰恰是养成习惯的前提。[13][14]
测算:一个20人班底按每人每月150美元的中位开销计,年支出约3.6万美元;若按Plus标价20美元计,则是4800美元。两者相差7.5倍。这个差额是否值得,取决于Agent每月替班底完成多少可验收的任务——而不是生成多少行代码。以当前公开数字,还没有第三方能回答这个问题。[13][15]
本文由News整理发布,仅供参考。
