


































Codex产品分析:从写代码的助手,到别人商品里的一个零件
反过来,最容易被高估的是扣子的「1亿Agent」。这1亿里绝大多数是没人长期使用的作品——低代码平台天然产出大量一次性bot。真正该看的是6月1日3.0做的那个反向动作:把Claude Code、Codex CLI、OpenClaw、Hermes一键接进项目空间,让本地Agent和云端Agent在同一个上下文里协作。平台的价值不在自己造Agent,而在让别人的Agent听它调度。官方订阅页甚至直接把「Codex等精选Harness框架」写进了套餐卖点。[9][28][10][29]
1.4 环境:四条新规则改变了采购逻辑
计量规则:三家都从「按席位」滑向「按积分/按token」。WorkBuddy每档每月500至20000积分,扣子3万至99.9万积分,Codex 12月起与ChatGPT共享token池。计量单位成了新品参数,也成了客户最难预估的部分。[19][21][11]
安全规则:三条不同的信任路径。Codex走「漏洞—补丁—安全产品线」,WorkBuddy走「等保三级/四级+ ISO 27001 + VPC专享与安全通信网关」,扣子走「开源可自托管+机构版VPC」。买家用哪条路径,取决于他更信「修得快」还是「数据不出门」。[16][20][21][30]
采购规则:渠道决定单量。Codex靠云行业(Bedrock、Model Garden)与企业服务支持网络,WorkBuddy靠腾讯生态与系统集成商,扣子靠头部券商、操作系统关键性银行这类标杆客户与开源自建。[31][7][24]
验收规则:产出越多,判断越贵。GitHub上每三个PR已有一个涉及Agent;OpenAI内部工程师每周合并的PR增加70%。写代码变快了,判断变贵了——这条规则对文档、表格、PPT同样成立。[32][15]
判断:这条赛道已经从「工具较量」进入「制度比拼」,而且制度是被生态预先写好的。谁的计量方式被财务接受、谁的安全性证据被审计接受、谁的采购路径被云预算接受,谁就能进企业的常规流程。模型能力只决定第一周的试用,制度适配决定第三年的续费;而制度,只能由握着IM、账号与采购入口的那一方来定。[18][20][16]
二、商品拆解:Codex
2.1 定位:八个节点,三次换壳
Codex不是一次设计出来的产品,它被改了三次壳:先是终端里的工具,再是能派活的平台,最后变成别人商品里的运行时。每一次换壳都换掉了核心用户与核心指标,这也是判断它下一步最可靠的线索。[1][2]
表4 Codex的八个定位节点(2025年4月至2026年9月)[1][2][15][3]
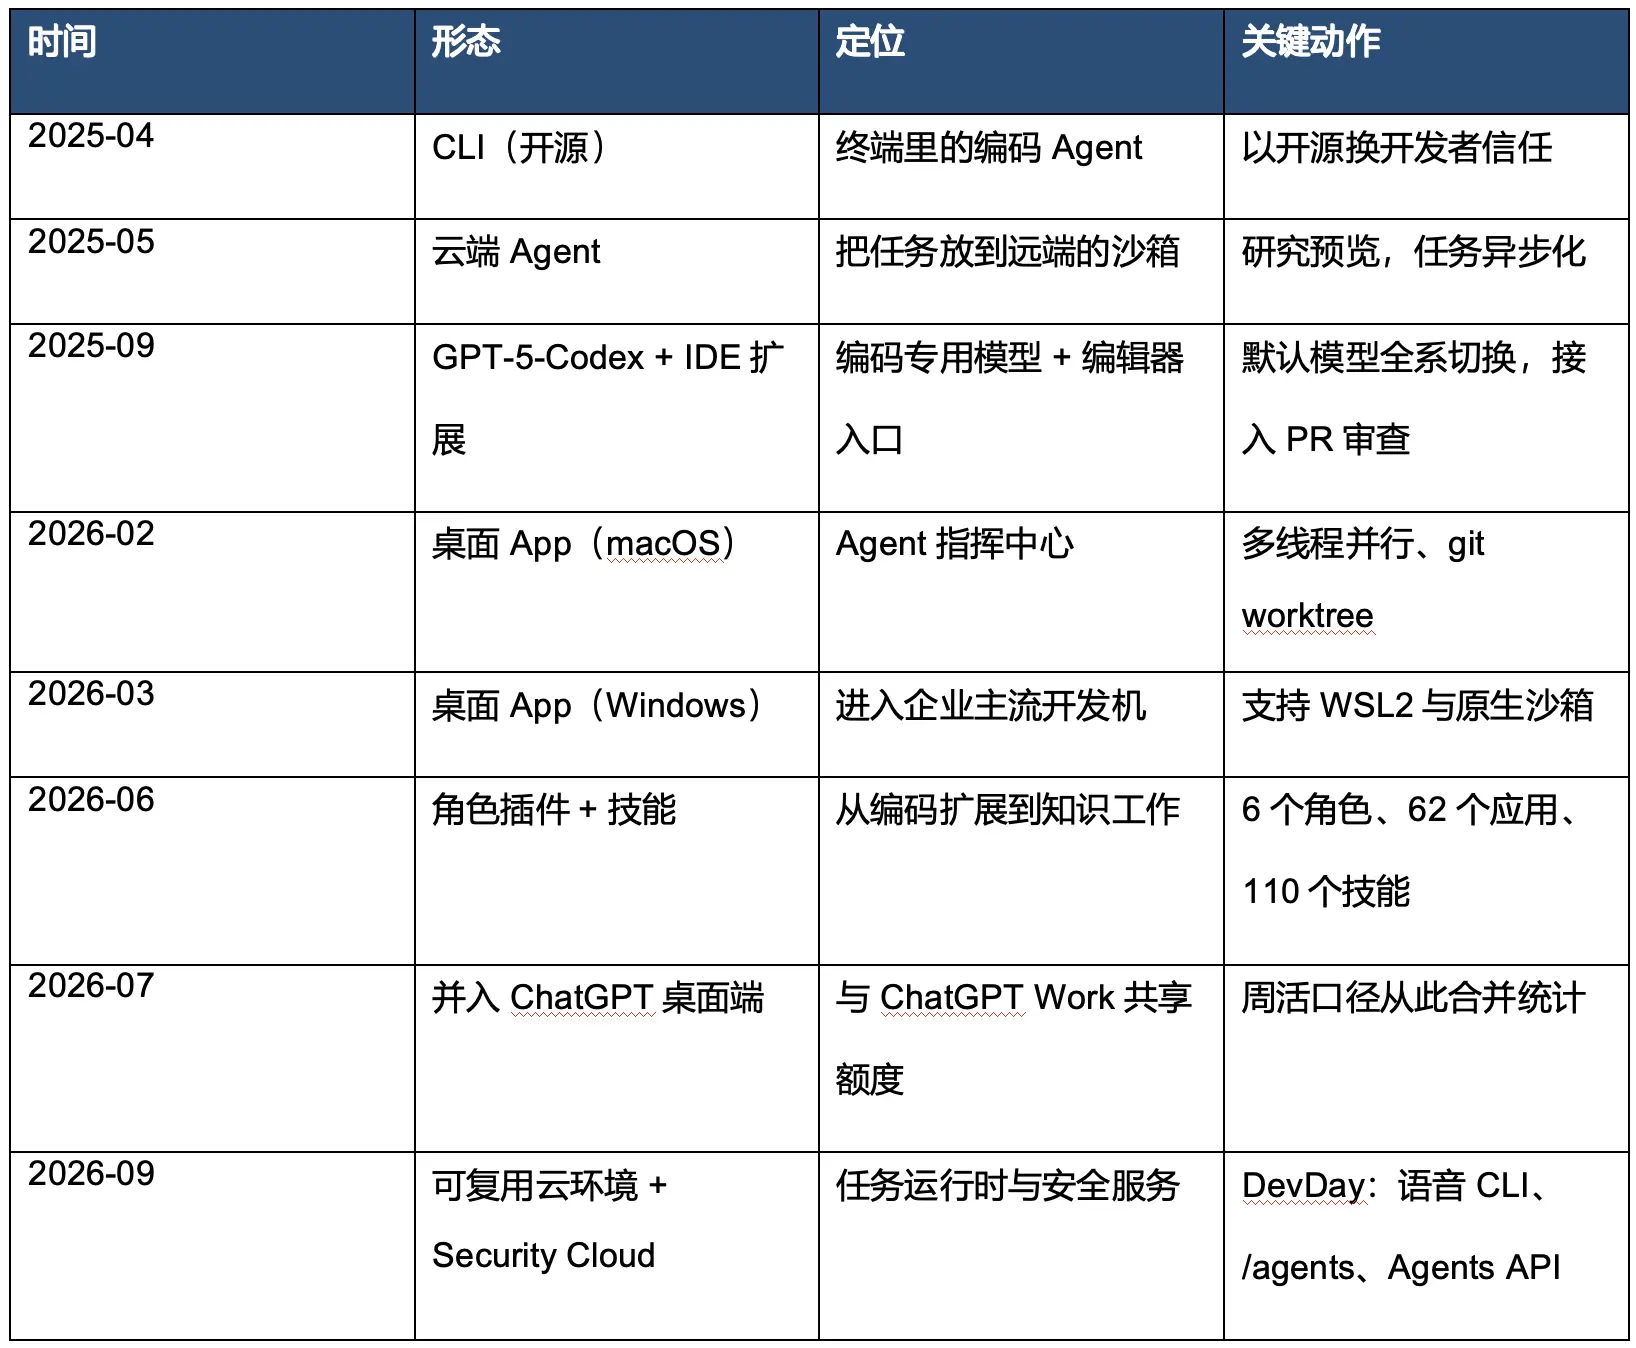
三次换壳的方向是一致的:把「模型能力」往后放,把「任务的发起、执行、验收」往前推。2026年9月的DevDay把这个方向讲得最清楚——可复用的云开发环境、能接语音的CLI、能同时盯多个Agent的/agents视图,以及可在笔记本合上后继续跑的Security Cloud。这些都不是模型功能,而是执行面的特性。[2][33]
桌面端是这条线上最容易被误读的一步。它不是「CLI的图形壳」,而是把工作单位从命令改成看板:左边项目、中间线程列表、右边评审面板。CLI解决的是「快」,桌面端解决的是「多」——多个任务同时跑、多个Agent各自在独立工作树里干活、人只在评审面板上做判断。没有这一步,后面的并行委托与云端环境都无处落脚。[3][2]
2.2 能力与资源:四项能力,三层资源
能力一:执行面,决定「能不能干成」
Codex的执行面是四端一云:CLI、IDE扩展、桌面App、ChatGPT的移动与网页端,加上云端沙箱。桌面端用git worktree让多个Agent在同一仓库并行而不互相踩踏,云端则提供可复用的打造环境——队伍里的新任务直接继承「已批准的设置与权限」,不必每次从零配环境。这一层解决的是长任务最常见的失败原因:不是模型不会写,而是环境没配好、跑到一半被打断。[2][3]
能力二:委托控制,决定「敢不敢放手」
放手的前提是随时能把方向盘拿回来。Codex在这一层的外观相当密:权限模式可按快捷键切换,任务进行中可以插话改方向(mid-turn steering),可以开侧对话(/side)而不打断主线,中断时连正在跑的工具调用一并停掉。再往上还有一层自动审查——Guardian会对Agent的产出做一致性核查,OpenAI内部几乎每个PR都走这条路。[1][15]
能力三:上下文,决定「知不知道该怎么干」
上下文分三层:项目层用AGENTS.md(跨厂商开放约定,而非自家私有格式),任务层用Skills把流程固化成可复用包,会话层用compaction在超长任务里压缩历史以跨窗口延续。2026年10月的更新里,网页搜索默认开启但走缓存索引,只有在全权限沙箱或显式配置时才抓取实时页面——这是一个很产品化的取舍:默认省钱,需要时才联网。[1][32]
能力四:治理,决定「组织敢不敢批量买」
公司要的不是更强的Agent,而是可被管理的Agent。Codex的治理能力包括Team Config(把班底的配置文件集中下发到各仓库与机器)、RBAC与SCIM、合规API与审计日志、以及Codex Security Cloud的持续扫描。这一层没有演示作用,却直接决定采购能否过审。[1][2]
能力小结:四项能力里,只有「执行面」是真正稀缺的。委托控制、上下文标准、治理能力都能被复刻,甚至已经被复刻;但四端一云加可复用环境的工程量与运营花费,不是三两个月能追上的。这也是Codex与「一个更强的CLI」之间最实在的差距。[2][3]
资源一:模型与算力,可以换但不能缺
Codex的模型序列换得很勤:GPT-5-Codex之后有5.1-Codex-Max(首个原生兼容跨上下文窗口压缩)、5.2-Codex、5.3-Codex,2026年9月切到GPT-6 Sol与Luna,10月又补上6.1 Sol、6.1 Terra。对用户意味着两件事:能力在涨,但「你用的Codex」每两个月就换一次内核,评测结论的保鲜期不超过一个季度。[1][34][35]
资源二:分发,从自有入口到别人的商品里
Codex的分发有四条腿:ChatGPT的十亿级用户底座、iOS与桌面端的远程派活、GitHub与GitLab的评审入口,以及云行业(AWS Bedrock、Google Cloud Model Garden)与厂商业务网络(Codex Labs与七家平台集成商)。最深的一条是把它做成别人的运行时——2026年开源的Codex Harness让开发者把Agent循环嵌进自己的软件,界面、统计结果与审批权留在新品侧。[2][36][31][37]
资源三:信任资产,最难量化也最难复制
OpenAI拿自己当样板:内部几乎所有工程师在用,周合并PR增加70%,几乎每个PR自动审查。外部则有Cisco(跨互联仓库理解与App Builder)、Ramp(评审)、Notion、Rakuten(故障响应)、Virgin Atlantic(测试覆盖)这些可点名的案例。这些案例的共同点不是「快了多少倍」,而是「进入了常规流程」——这比任何跑分都更难伪造。[15][36][38][39]
2.3 场景与体验:三个场景,三种验收标准
场景一:长任务托管
本文由News整理发布,仅供参考。
