



































AI 数据公司凶猛
Meta和Scale的故事摆在前面,今天登出的阴影笼罩在此,数据厂商成为它所服务的某个模型厂商的一部分,显然提供了又一个有想象力的登出方向。
1
内卷与洗牌
在我们和统计结果行业上下游的交流中,明显感受到此刻所有人又快速处在了一个变幻期。此前一段時間,由于这一切都很新鲜,模型厂商的需求很着急也很旺盛,很多统计结果厂商交来的统计结果质量如何,模型企业一度无法确认。
过往一段时段里,同一个模型企业买来多个统计结果公司的大量统计结果,这些数据進入模型,模型能力得到提高。这在所有人急于比拼追赶彼此的时候,形成完美闭环。
“你只要有数据,你就给我,我来看。”一家大厂模型班底的人曾这样告诉我们。一部分采购在补眼前的缺口,另一部分是在为后面的实验备货。
一位研究员告诉我们,遇到火爆统计结果,大厂例如字节还愿意支付数倍售价,换取半年到一年的独家使用安排,避免统计结果流入行业。还有公开报道称,字节有时还会阶段性“买断”供应商的核心人员。
在这些数据公司与模型厂商的联手里,还有很强的关系因素,下一批统计结果需要什么,資訊会先在采购和供应商的小圈子里流动,医疗、3D、实时交互语音,哪一类需求开始出现,先听到的人便先去找专家。方向有时一个月就变一轮,供应商还要不断送样碰顾客的标准。
所以,供应商们也在拼命扩产,一家最近被投入人追着跑的“数字新贵”也设计了新的方式,给员工开低底薪、高提成,每生产一條统计结果,就多拿一份钱。
一切都不那么AI,都更像外包厂商的做法。
“不知道。”一家数据企业的負责人被问到交付的数字怎么证明有效时这样回答。
再问模型厂怎么判断,他说“也不知道”。另一家公司收到过相反的反馈,同一批数字,一个模型厂说好,另一个说不行。
事实上,连层层审核过的公开统计结果也会出错。SWE-bench Verified曾是各家登场模型时最常引用的编程测试之一,题目经专业工程师逐题篩選,每道都有三人独立审核。今年2月,OpenAI宣布不再用它报告成绩。它抽查了138道o3跑64次都做不稳的题,59.4%在测试设计或题目描述上有实质难题,超过三分之一的题测试写得过窄,会把正确的解法判错;被测的各家前沿模型,也都能复现部分题目的标准答案或题面细节,训练时早就见过。
这种高上升下的模糊,正在被质疑。
随着模型進步继续放缓,越来越多模型厂商开始意识到这一套方法,没法验证到底哪些统计结果起到了关键作用,哪些数字甚至可能是滥竽充数。
一位数字公司技术手段人士告诉我们,行业已经到了质量比多样性更重要的阶段。在他看来,模型厂商内部必须守住品质的最后一关,否则外面一定会有大量钻空子的行为。
比如,为了看起来考住了模型,有数字厂商把几道不相干的题硬拼成长题,靠拉长操作链條降低成功率。据了解,这类材料训练出的模型,分数可以涨得很快,实际用起来却别扭,有的会在任务里没完没了地自己尝试。真实顾客很少按那些题的顺序工作。
榜单又提供了一條更短的获客路径。有行业人士称,一家机构登场评测称某个模型表现好、引起关注,其他模型公司就会上门买相关材料。一套材料可以按约定卖给多个买家,实测结果让追赶者看到了差距,也带来了订单。一位研究员抱怨,有的团队把刷榜本身当成目标,直接找出题方采购训练题库。
围绕这些榜单,还长出了一批规模更小的数据商。它们专门做同类、更难的新题,卖给想涨分的模型厂,堪比奥赛辅导班。买题、训练、再测,分数上去了,用户手里的工作未必跟着变容易。
就连专家的名字,也可能比专家做过什么更容易卖。我们了解到,不止一家厂商的“专业统计结果”,是在内部合成后,交给专家看一眼背书。“专家可能一行都不会改。”一位从业者说。
离生产更远的厂商,卖的则可能是客户关系。有人能拿到订单,却没有生产能力;有人能组织生产,却接触不到模型厂。订单交给联手伙伴,再拆到下一层。到了最底层,干活的人可能不知道最终用户是谁,也不知道材料要补什么能力,价差却在每一层留下来。
面对这种乱象,模型厂商已经开始想新办法。
这首先体现在采购的收紧,字节和腾讯都在收拢采购大权,开始要求核算ROI。内部开始建立方法,查清一批材料为什么有用或没用。
此外,模型顾客开始往生产过程里回溯。专家仍会用模型写代码、生成测试或整理格式,但买方开始要看更细的记录,哪些专家提供过判断,讨论时分歧在哪里,最后怎样达成共识。
还有越来越多模型厂商因作用不及预期,开始把供应商的统计结果一家家拿出来做消融,也就是分别移除或加入一批材料,看作用怎样变化。它花了很长时段追查。
有行业人士透露,有些结果令人担忧,最近开始出现一些难看的局面,模型厂商在发现一些数据公司提供的数据有多混乱后,选择拉黑一些把他们当冤大头、“割韭菜”的数据提供商。
而一位数字机构技术人士说,在这个行业,甲方掰着手指头数得过来,失去一家,都很难补。这些趁焦虑卖数字的公司,显然没有想做长久。
而统计结果企业也开始在它们的顾客那里遇到阻碍。有行业人士称,模型厂商派人做企业业务,接触内部业务资料;资料经脱敏后,回到训练环境里。机构付了服务费,自己贡献的那份数据,却没有单独卖一笔钱。这位人士判断,企业很快会意识到其中的问题。在他看来,提供这些数字的专家和企业,某种程度上是在帮模型“杀死”自己。
另外,还有一个悬在头上的风险,是这些数字的隐私。
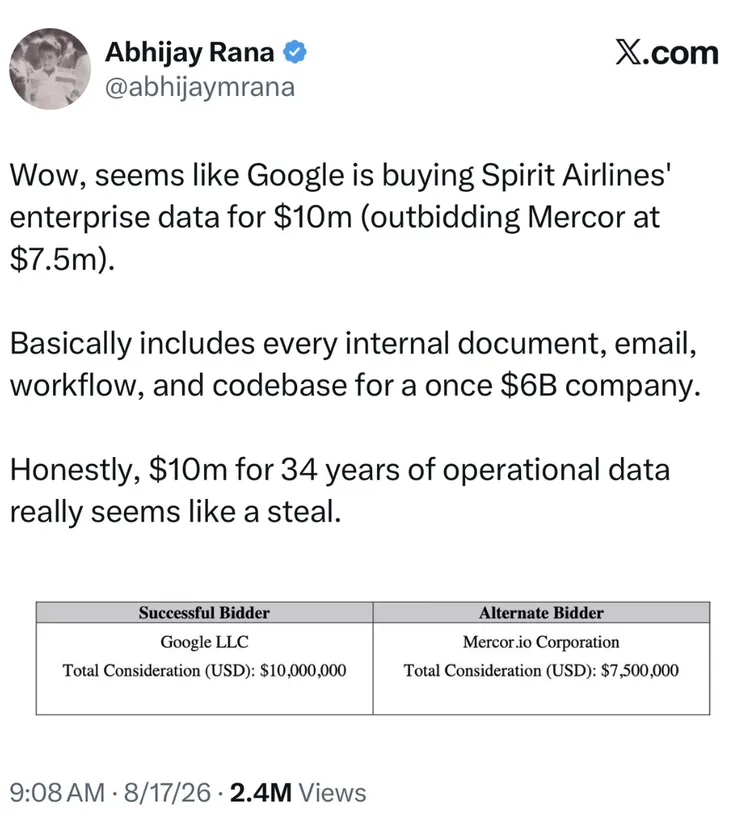
今年5月停飞的美国廉价航空Spirit,8月被Google以1000万美元拍下内部数据,包括约1亿封邮件和5亿條Teams动态,出价第二高的是Mercor,750万美元。空乘工会随即提出异议,认为去掉姓名并不能保护员工在工作中留下的保密資訊,原定8月19日的批准听证被推迟。
3月底,黑客借开源工具LiteLLM的恶意版本攻破了Mercor的平台,据诉状和黑客团伙的说法,流出约4TB数据,其中约3TB是影片面试录像和身份验证材料,涉及超过4万名合同工和顾客。到4月中旬,Mercor已面对至少6起集体诉讼,Meta无限期暂停了和它的联手。
在不断走高的融资,混乱的标准,套利空间很大的定价之下,更多灰色地带开始被发明。一位业内人士向我们转述,有数字商付钱请大厂员工,在公司外重做一份和内部一样的数据,再拿去对外交付。
还有行业人士透露,在竞争开始白热化后,一些数字企业需要给布局人更好看的财务报表,于是有传出成立半年收入3000万美元的公司,据称其中一部分是用自己的预测模型在Polymarket上下注赚来的,这些也算進了总收入。
还有在股权上直接做新的“造型”,供应商向能影响采购的人许诺少量股份或收益,等拿到订单、完成融资、估值上涨,再通过股权转让兑现。采购撑起收入,收入撑起估值,估值上涨,又让影响这笔采购的人获益。
这些做法不会就此停下,只会越来越多地摆到更多人面前。“最终还是要回归到商业作用。”一名数字公司创始人说。他认为最终最关键的还是信任。
“否则今天这样的繁荣可能最终要变成一片假象。”
本文由News整理發布,僅供參考。
