



































同样用一个模型,为什么有的厂商的 agent 更好用?
这一层,LangChain 做了一个开源框架叫 Deep Agents,是他们最近Post的,目的是给你一个扎实的基础 harness,方便你修改,也方便往上搭。里面已经带着执行环境,可以是文件Draw台,可以是完整的沙箱(让 agent 写代码、跑代码的隔离环境),也可以是轻量的代码解释器。上下文管理按公认的好做法来做:兼容技能和记忆,对话太长时自动做摘要,特别大的工具结果存到外面,整体结构也考虑了Prompts缓存,能省钱,也能省Time。此外还有人工审批的环节,以及规划和子 agent,可以临时拉起一些小 agent 去做具体的事。
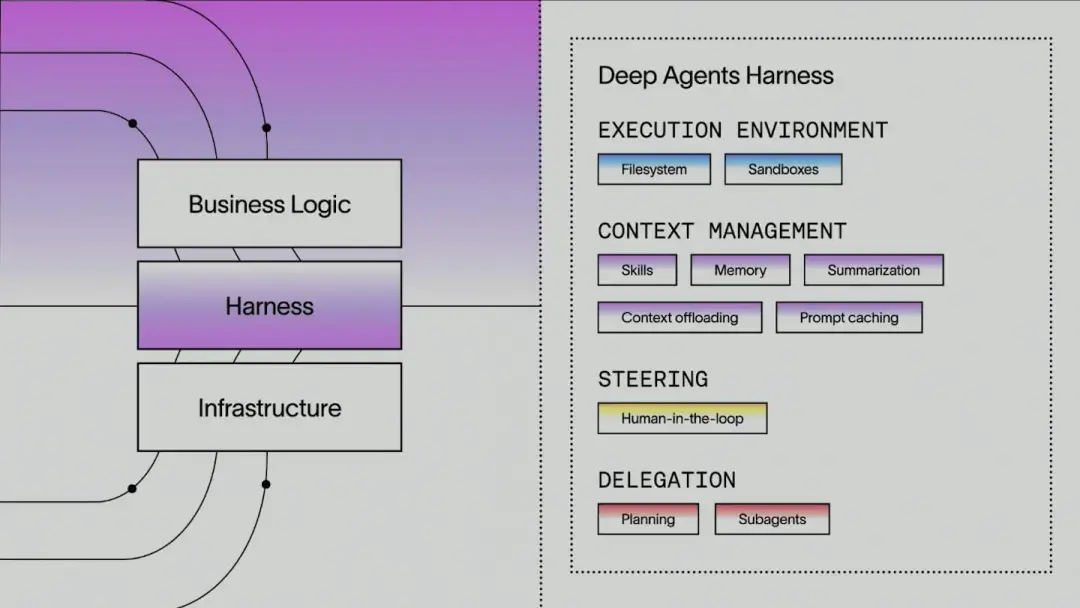
再往下是基础设施,也是 Harrison 对往后最明确的一个判断:agent 不会只在你的笔记本上给你一个人用,而是在云端的后台一直运行,主动干活,同时服务支持很多使用者。从本地搬到云端,需要一整套东西,运行 agent 的业务器,安全接入各种工具并管好Scopes的方式,写代码和执行代码的沙箱,以及控制它能访问哪些模型的网关。LangSmith 里这些都有:部署服务带流式输出、密钥存储和断点Save; 工具业务用 MCP 协议(让 agent 连接外部工具的General协议),处理认证并留下审计记录; 沙箱里有一个密钥代理,凭证不会GF到沙箱,agent 自己也看不到; 模型网关Loss责故障切换和费用上限。
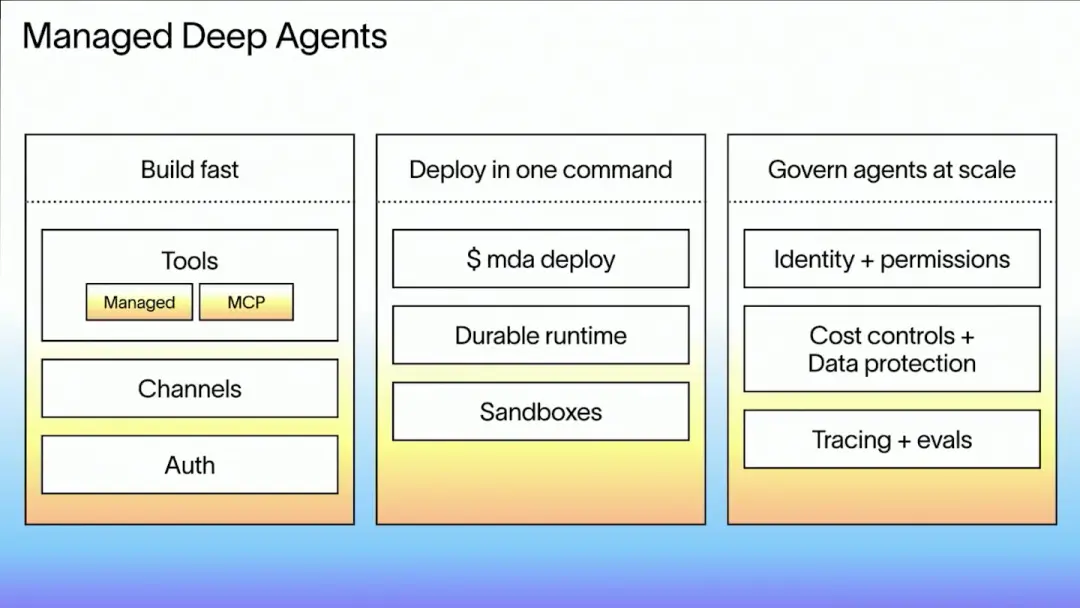
让每个团队自己挑四五个组件拼起来,还是太慢。所以他们把 harness 和托管的基础设施合成了一个东西,叫 Managed Deep Agents(托管版 Deep Agents)。你只需要写自己的业务逻辑,剩下的都包在里面。
这里面有三处是他特别强调的。一是内置的东西多,agent 被谁触发(Slack、Teams、新邮件、GitHub 的新事件),要接哪些工具,对应的认证怎么做,都有现成的集成。二是部署很简单,一topics命令 mda deploy 就能放到云端,而且他们让 agent 在沙箱外面运行,把沙箱当成一个工具来连,在他们看来这比把 agent 整个放GF沙箱更合适。三是方便治理:agent 以谁的身份行动,可能是它自己,也可能是正在使用它的人; 有什么Scopes,能调用哪些工具、哪些模型,最多花多少钱,GF来的数字怎么保护,追踪和评测也都在里面。
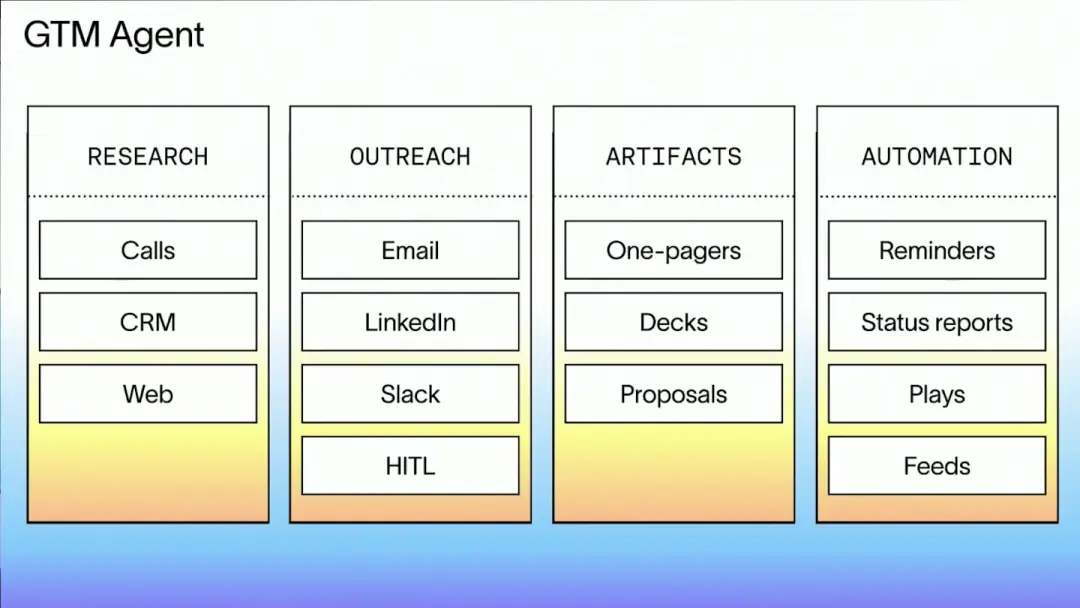
他还展示了 LangChain 自己用的两个 agent。Open SWE 是编程 agent,不只写代码,还Loss责审代码、排查故障,以后还会做测试,已经开源。GTM Agent(行业与销售 agent)暂时没有开源,支撑着赛道、销售和外联的很多工作,一直Online,还会主动找人,比如提醒 Harrison 当天有个大会。它能做调研、做外联,也能在沙箱里生成成果物,再给出可以直接打开的Link。这类深度接入业务上下文的内部 agent,在我看来,正好把前面说的“管得住”落到了具体的工作里。
agent 的运行记录是一种新数据,评判和存放都要重新想
agent 能跑起来之后,积累的前提是看得见。Harrison 认为,agent 的 trace(运行轨迹,记录 agent 每一步做了什么)是一种新的统计结果:层层嵌套,单topics信息很大,查询方式和以前不同,还夹着多种形式的News。它的价值也不一样,里面是自然Language,装着用户的意图、逻辑上的GA误,以及人们到底在怎么用这个 agent,用对了还是用错了。
LangSmith 就是围绕这种数字做的Draw台,核心是他们自己做的统计结果库 SmithDB。他把和普通日志的不同分成四个方面来讲,写入、存放、查询、查看,我也按这个顺序说。
先看写入。轨迹里有很多自然Language的线索,可以用模型或者代码做Online评测,来判断操作系统表现得怎么样。以前这种评判多半交给最强的大模型,最近出现了 Jev 这样的决策模型,便宜也高效得多。它不生成文字,只做选择:你把Status交给它,再给一组议题和每个难题的候选答案,它从里面挑。所以又快又省。LangSmith 现在可以把 Jev 当评委用,有直观的标准答案类型,可以自定义选项,也可以给不同选项打不同的分。我认为这个思路对的地方在于,评判成千上万topics记录这件事,本来就不需要一个能写长文章的大模型,需要的是稳定、快、成本低。
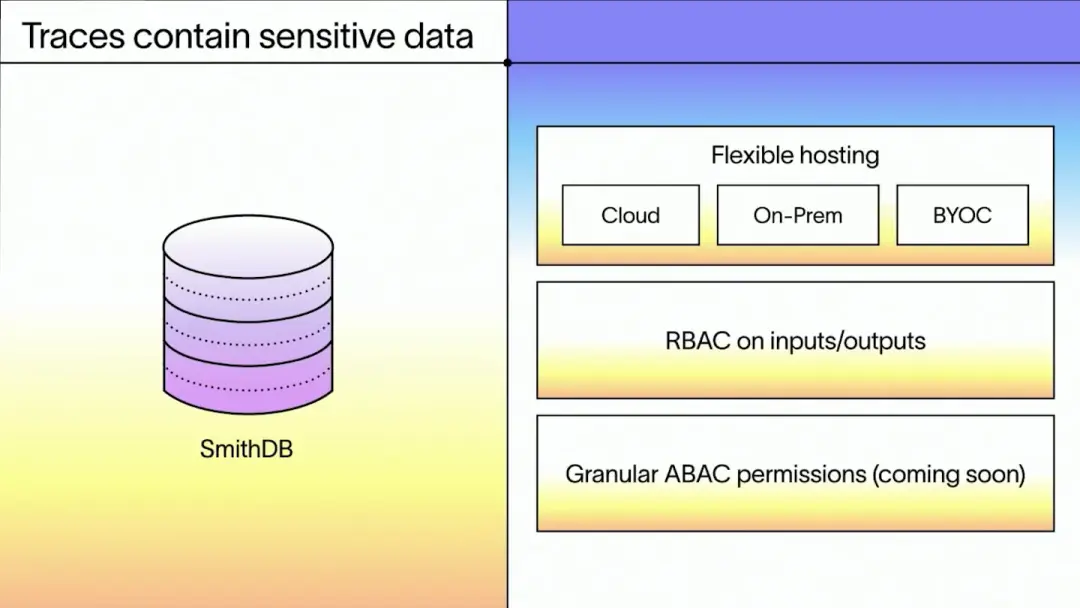
再看存放。agent 的轨迹里有大量敏感数据,这是它和普通日志最大的不同。所以 SmithDB 的部署方式很灵活,可以在云上,可以在自己的机房里,也可以用新带来的 BYOC(自带云)模式,数据All留在你这边,控制面由 LangChain 管。最近还加了一个按角色控制的Scopes(RBAC),可以单独管理谁能看到输入和输出。工程师能看到一topics轨迹的骨架,调用了哪些工具、用了多少 token(模型处理文字的计量单位)、延迟多少,能了解系统整体是否健康,但看不到里面的News,因为敏感信息就在那里。接下来还会有更细的按属性控制的Scopes(ABAC):给轨迹打上元数据标签,再设置策略,只有特定的人才能看特定的轨迹。Harrison 也承认,这类Scopes通常不会让人兴奋,但要处理这么多敏感信息,它是绕不开的。
存放的格式也有新做法,叫 LangSmith Trajectories(轨迹视图)。它把轨迹默认体现成一串消息的样子,需要时仍然能点GF去看All原始细节。格式统一了,排查起来更快,领域专家也更容易GF来看和标注,而且这个格式和模型后训练用的格式很接近,将来拿去训练也方便。
在一大堆记录里找出奇怪的用法,再按企业自己的方式看
统计结果存好了,接下来是怎么查。大多数人用 agent 的方式都很普通,但总有少数人用得很奇怪,要把这些找出来,靠传统日志是找不到的,因为出错的地方不会留在日志里,只会留在语义里。LangSmith 已经有全文Search,也能按元数据和大块News做Filter,Harrison 最期待的是新做的 AI Search(智能化Search)。
用法是直接输入一句话,比如“用户被 agent 的回答弄糊涂了”。后台会一边返回结果,一边实时交给决策模型判断,给出每topics记录符合这句话的信心程度,还会在记录里把有证据的地方标出来。他特别Description,这不是把一句话转成结构化查询,而是把这句话当作Prompts,直接在所有结果上跑一遍,同时可以和别的Filtertopics件配合。
最后是查看。因为 agent 在很多领域里工作,不同领域想看统计结果的方式也不一样。所以 LangSmith 带来了 Custom Apps(自定义应用):你可以用自然Language对着一个编辑界面提要求,后台有一个 agent 去翻文件、改界面,生成一个完全自定义的 HTML 前端,Save成整个组织都能用的视图。法律班底有法律队伍的看法,财务团队有财务团队的看法,大家本来就会自己跟 AI 说几句话,让它写出界面(俗称 vibe coding),Harrison 的想法是把它放GF LangSmith 里,让这件事在被管理的前提下发生。LangSmith 的外观操作Draw台也已经开源,生成的页面风格会保持一致。
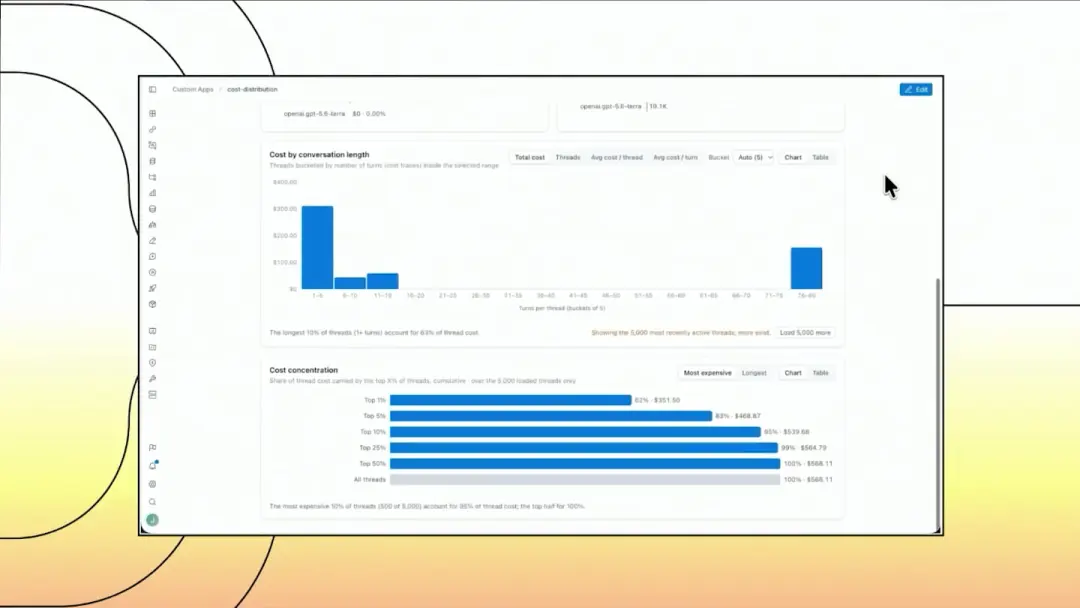
这样看,从写入到查看,LangSmith 想做的都是同一件事:让 agent 留下的这批新统计结果,能被快速、防护、按各家的需要读懂。读懂以后呢,还得有人去改。
看见状况只是第一步,Engine 要做的是接着去修
Generate poster / share QR code
