



































SmartPerfetto v1.15.1 更新说明
SmartPerfetto v1.15.1 是 v1.15 的修复版本,补充了原生 SQLite 安装诊断、测试数字隔离和 npm 消费项目的安装验证。v1.15 引入的逐轮源码与文档选择、答案交付和核验流程继续保留。
从 v1.14 升级时,还会获得进程实例隔离、呈现节奏、堆转储攀升和 CPU 簇负载修复。旧的内置 Android Internals Wiki Pack 和几组停用 API 已移除,已有调用需要检查迁移说明。
项目地址:Gracker/SmartPerfetto。
v1.15.1:安装后检查 SQLite,测试使用独立数据
smp doctor --format json 新增 sqlite_native 检查:打开独立的内存 SQLite 数字库,执行 SELECT 1,再关闭连接。缺少原生绑定、查询失败或关闭失败都会报错,AI 关闭时也会执行。这个探针不读取用户的持久化会话库;--version 和 --help 能运行,并不能证明原生数字库已经可用。
公开 npm 安装后的烟雾检查也增加了实际操作。检查在独立消费项目中显式批准经过审核的依赖版本,验证 doctor 的 SQLite 检查,再用固定版本的 Trace 测试文件执行真实 SQL 查询。发布者的 allowScripts 不能替消费项目授权。安装时如果 npm 提示依赖脚本被 blocked 或 skipped,需要先审查相关脚本,再按安装方式批准所需依赖;具体步骤见 CLI 安装说明和 npm 安装策略。是否受影响取决于 npm 的版本与配置,不能只凭版本号判断脚本一定被阻止。
相关测试改用各自拥有的临时统计结果库和数字目录。Agent 路由集成测试在导入运行模块前设置统计结果库、Provider、日志和场景产物目录,先结束自有会话、流和存储连接,再删除临时目录。这些测试不再依赖默认客户数字库,日志清理也限制在测试目录内。
在输入框旁选择本轮上下文
源码库和知识库的选择入口移到了输入框旁。展开「上下文」后,可以分别选择本轮使用的源码和文档;「管理…」负责注册目录、修改范围和维护可选索引。
源码仍然可以按需搜索和读取,不必先等整个工程建完索引。搜索结果会优先考虑声明位置和 Trace 标记,模型也可以查找文件、读取某一行附近的实现,再把对应位置写进结果。源码深度提供智能判断、快速定位和完整分析三个选项,用来控制读取预算。
读取预算与发送授权各有自己的作用。源码范围、可发送的文件类型和正文授权需要经过披露与确认;每次模型调用前都会再检查当前授权。文档知识库也要单独允许发送给 Provider。更大的读取预算不会自动扩大已经同意的范围。
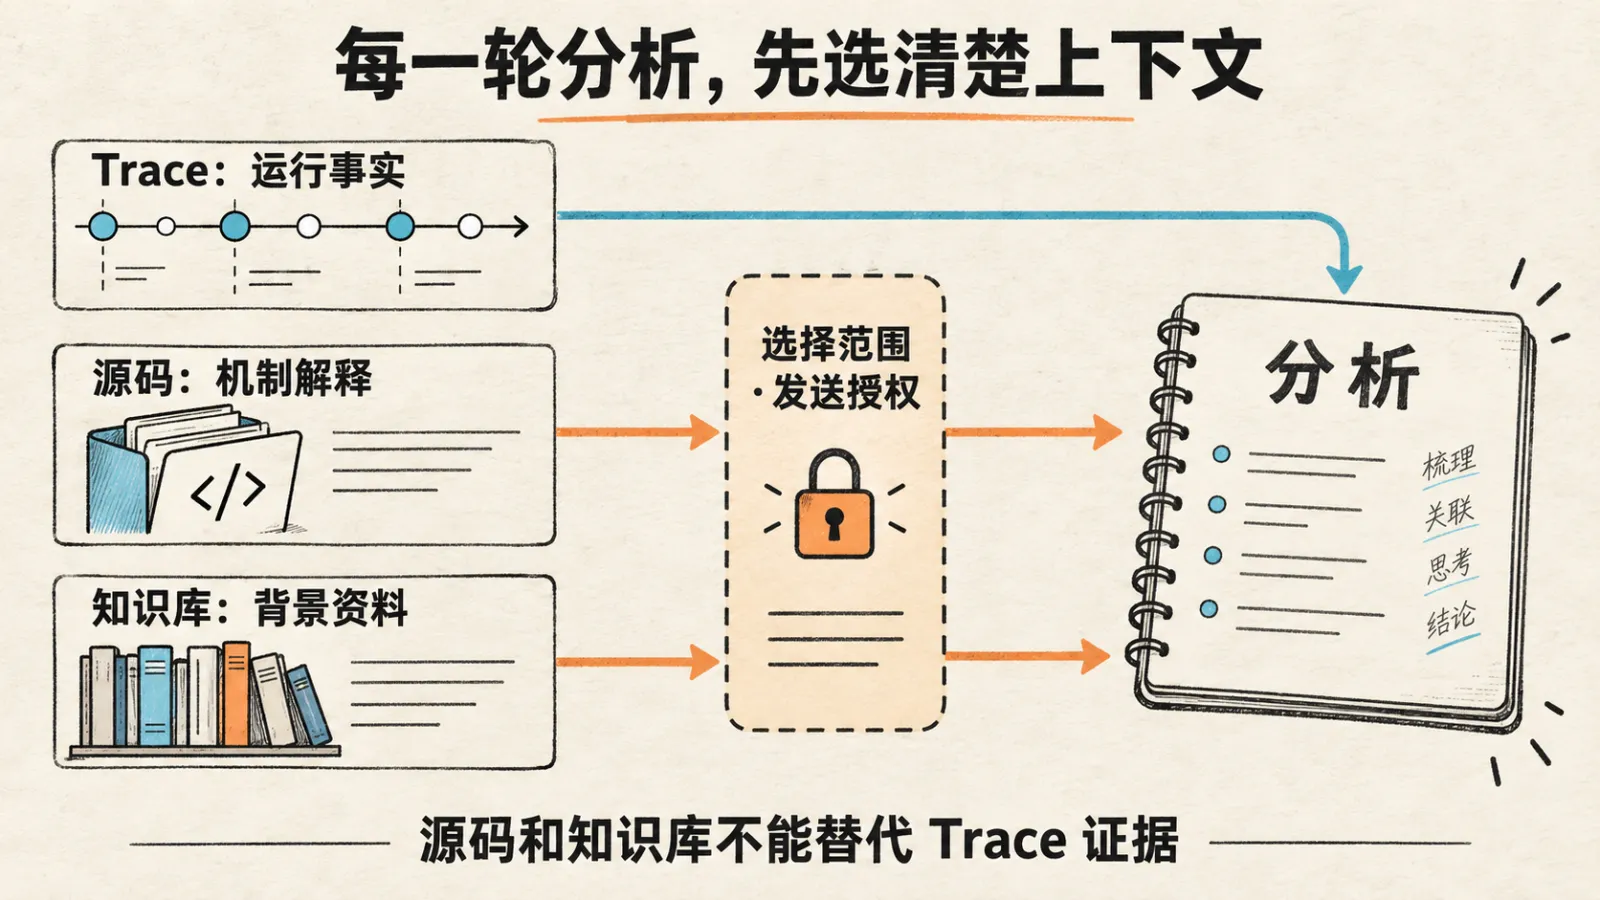
Trace 提供运行事实;源码用于解释实现;知识库提供背景资料。图中的箭头表示输入角色,不表示已经证明因果关系。
例如,Trace 中看到一段主线程等待,源码可以帮助定位对应调用和实现,文档可以解释操作系统机制。等待由谁造成、是否拖慢了当前场景,仍要看本轮 Trace 的调度、调用关系和时刻范围证据。
文档文件夹可以直接作为知识库
现在可以注册普通文档文件夹,让模型在选中的知识库里搜索并读取章节。Web 提供文件夹选择、索引、授权和删除操作,CLI 也有对应的管理命令。
Android Internals Wiki 在这里改成了普通文档知识库。需要使用它时,注册自己有权使用的文档目录,再按轮选择。安装包不再附带旧的签名 Knowledge Pack,smp knowledge-pack 命令也已移除。历史会话和报告里已经保存的背景引用仍会保留。
v1.15 增加的 smp knowledge consent --enable|--disable 可以修改已有知识库的发送授权。Web 在开启前表明确认说明;CLI 的 --enable 表示授权,并在成功后输出发送、保存与业务方留存说明。模型实际读了哪些文档,也会记录使用回执。
答案先出现,核验随后完成
提供答案流式输出的运行时,会在模型写作时展示临时草稿。正文生成后,同一个回答位置会显示完整答案;需要语义复核时,旁边保留待核验提示。最终事件到达后,才表明这一轮的交付状态。
草稿只存在于当前体现中,不写入历史。HTML 报告、CLI 文件和分析快照继续保存最终结论、声明和证据来源,方便之后比较或复查。
本轮选择了启用的源码库或知识库时,生成的报告和分析快照只对创建者开放,不能切换为工作区共享。发送给 AI 服务支持的文本仍受该业务自身配置与留存规则约束。
停止操作也随交付阶段变化:正文出现之前,停止会取消整轮;正文已经交付、复核还在进行时,第一次停止只结束复核,结果保留未核验状态。Web 再次停止会进入有界的强制停止流程。CLI 文本输出在正文出现后,第一次 Ctrl-C 也只停止复核,但第二次会取消整轮且不保存;复核停止后超时未提交,也不保存。JSON 和 NDJSON 不输出临时草稿,第一次 Ctrl-C 就取消整轮。
v1.15 已把五个运行时的最终状态统一交给商品侧处理。运行时负责记录原生完成情况,以及是否需要一次有界的声明修复或正文补全;最终核验负责判断声明与证据、正文是否相符。Provider 报错、超时、用户取消和核验失败分别记录。
滑动分析同时看呈现节奏和帧耗时
滑动概览现在把呈现节奏放在帧耗时旁边。FrameTimeline 标记、Buffer Stuffing、相邻呈现间隔和 doFrame 起点间隔各自保留原来的含义。
这对高刷新率场景尤其有用:一批帧带有 Buffer Stuffing 标签时,还需要看实际呈现是否均匀,以及有没有混合的 Missed 或 Dropped 证据。缺少呈现观测时,结果会说明尚未测量,不能拿 doFrame 起点节奏代替上屏间隔。
点击响应分析也分清了物理输入、应用投递和 monitor 副本。根据时间接近推测出的帧关联,会继续标为候选;它不能直接计作已经确认的上屏响应。
进程实例隔离和 CPU 负载修复
点击响应、CPU 和启动详情支持更明确的进程实例范围。这里使用 UPID——Trace 内的进程实例标识。软件重启后,即使包名没有变化,旧实例的证据也不能自动归到新实例。
测试会在相同包名、其他进程和重启实例之间检查 SQL 的隔离情况。它检查查询是否依赖所选 UPID,而不只检查是否成功执行。
v1.15 的发布审查修复了 CPU 簇负载的两处计算问题。原先窗口分母扣除了休眠时段,Running 区间的分子却仍按墙钟累加;区间跨休眠时,测试能得到 200% 的负载。现在两边统一使用单调时钟;任一转换不可用时,两边一起回退墙钟。整个窗口都在休眠时,醒着的时长和活跃核心数为零,负载百分比为空。
另一处发生在多设备 Trace:两台设备的 CPU 0 不能合并成一个核心。身份无法区分,或 CPU 元统计结果存在歧义时,簇负载会返回不可用成因,相关数值为空。单设备仅缺少容量信息时,未分类核心仍可以测量。修复没有把超过 100% 的结果直接截到 100%。
此外,堆转储分析增加了类首尾提升、可达实例和 dominated 大小的观察;框架进程状态、wakelock、standby、freezer 与持锁方区间也保留各自的数字缺失和能力限制。
本文由News整理发布,仅供参考。
