



































SmartPerfetto v1.1.1 更新说明
本文复盘 上一篇三周更新(2026-06-04,v1.0.28)之后,到 2026-07-17(v1.1.1)为止 SmartPerfetto 的全部主要改动。看完这篇文章,可以知道这六周每个特性解决什么问题、边界在哪里,以及当前版本的完整功能全景。项目地址:github.com/Gracker/SmartPerfetto。
一、变化概览(2026.06.04 – 2026.07.17)
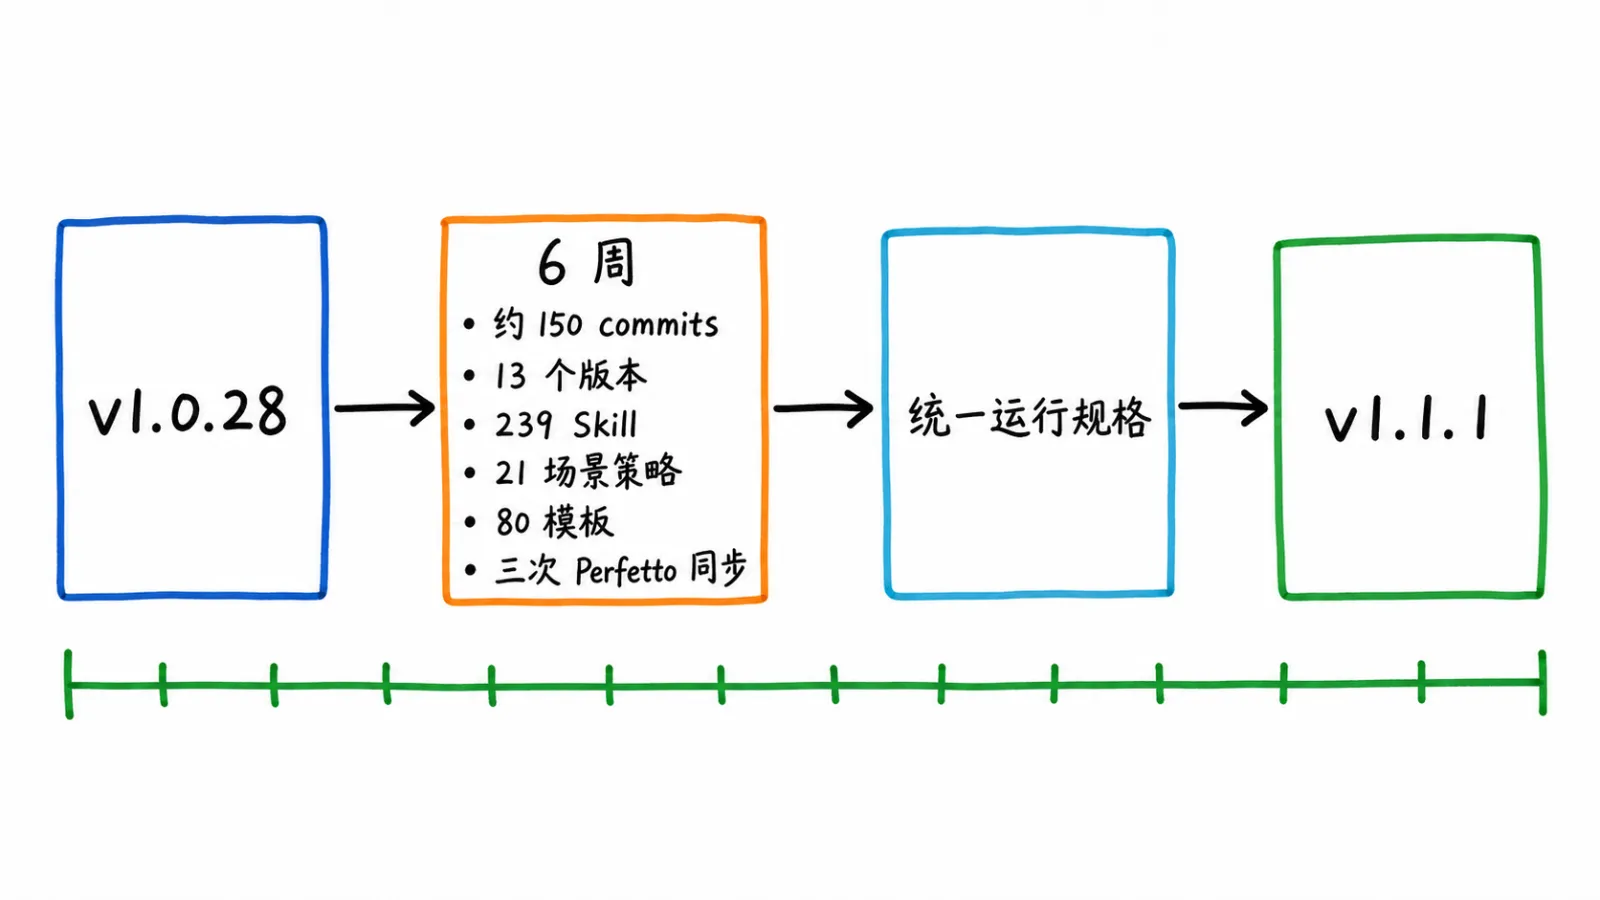
这六周合入了约 150 个提交(不含 merge),登场了 13 个版本(v1.0.29 → v1.1.1)。如果说上一篇文章的主线是”把四条 Agent 运行时都跑通”,那这六周的主线就是把四条运行时收敛到同一套契约之下,同时在分析使用感受、场景知识、公共生态三个方向持续扩展。
先看几个可以量化的数字(按仓库内约定的统计命令计算):
| 指标 | 2026-06-04(v1.0.28) | 2026-07-17(v1.1.1) |
|---|---|---|
Skill YAML(*.skill.yaml) | 226 | 239 |
场景策略(*.strategy.md) | 20 | 21 |
策略/提示词模板(*.template.md) | — | 80 |
| Perfetto 上游同步 | — | 期间同步三次:v56.0 → v57.1 → v57.2 |
| Agent 运行时 | 4 条并行 | 4 条,共用统一运行规格 |
下面按对日常分析工作流的冲击从大到小逐个展开:先讲改变使用方式的能力(双 Trace 工作台、Quick Mode),再讲改变能力上限的能力(私有分析上下文、运行时统一),最后是场景、知识、生态和工程化。
二、双 Trace 分析工作台
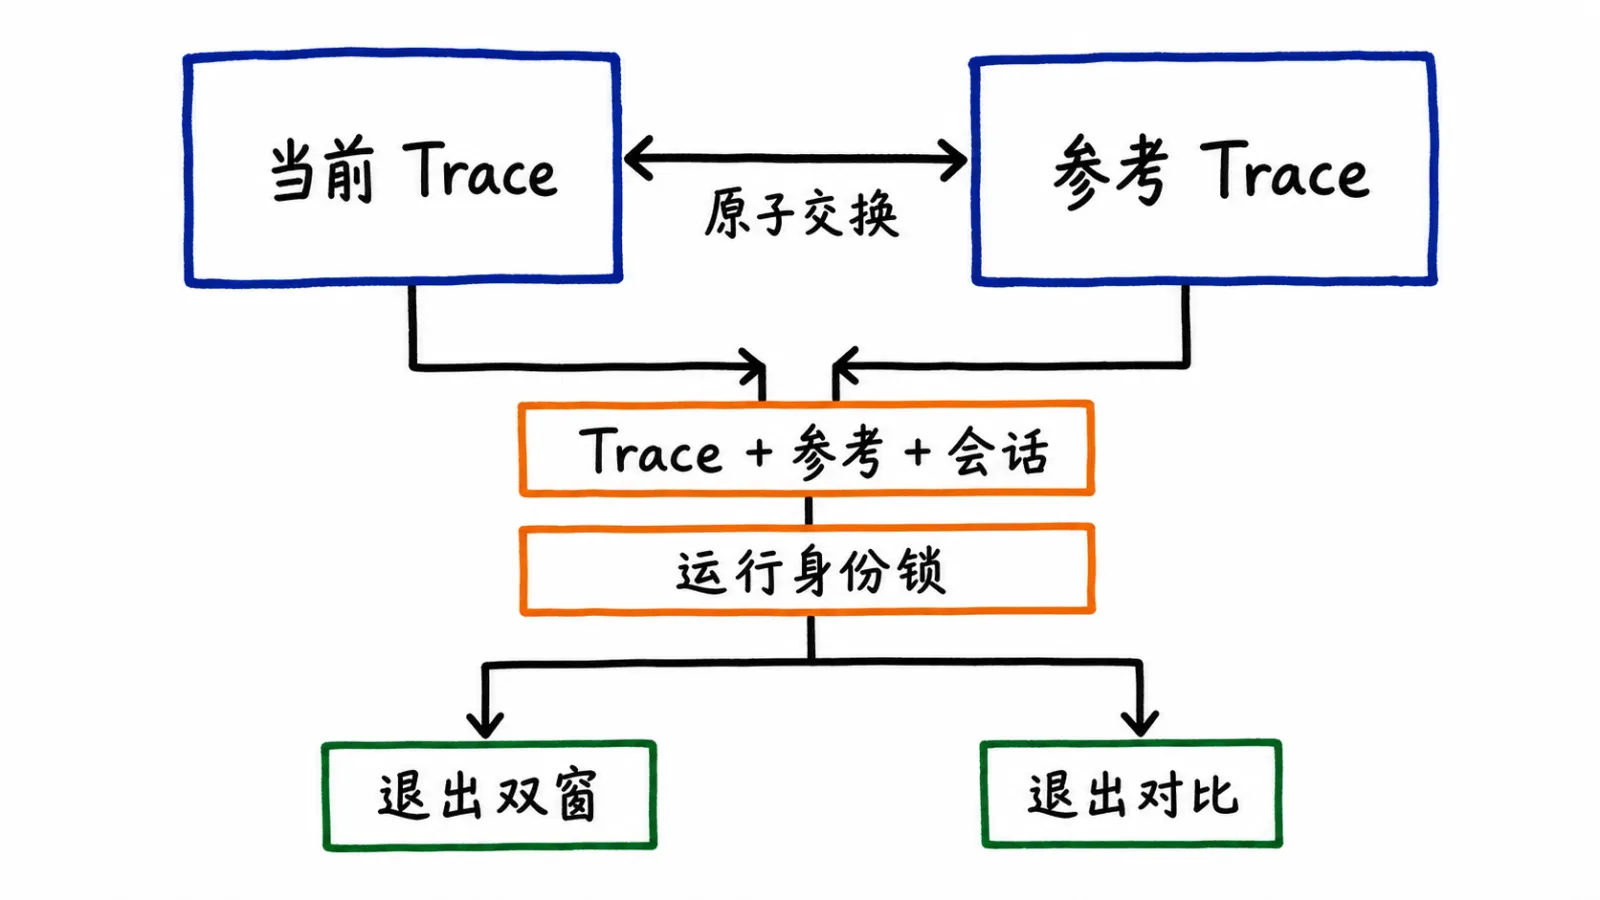
性能优化的核心动作是对比:优化前后对比、竞品对照、平台版本更新回归。此前 SmartPerfetto 已经提供在 AI 会话里挂一个参考 trace,但界面上只有一个时刻线窗口,”两条 trace 对着看”这个最自然的动作做不到。7 月 10-11 日(v1.0.39)落地的双窗工作台补上了这一块。
使用路径设计成最短的一条:
- 一键进入:AI Panel 顶部有直达的”打开双窗”按钮,点击后立即出现双窗——一个窗口表明当前 trace,另一个窗口为空,从 workspace 历史里选参考 trace,不需要先进 trace 选择器。
- 窗口身份原子交换:两个窗口都有 trace 选择器,使用者可以自由决定哪个窗口放当前 trace、哪个放参考 trace。在当前窗口里选中历史 trace 时,当前 trace 会原子移动到另一个窗口,不会出现两个窗口显示同一条 trace 或者中间出现”无主 trace”的状态。
- 运行身份保护:分析运行期间,”当前 trace + 参考 trace + agent 会话”构成同一个运行身份。此时切 trace、退出对比、切 Provider、换 workspace 都会被拒绝,只有显式 Stop 才走后端取消协议;而布局切换、最大化、拖拽、AI Panel 折叠只改展示状态,不销毁 iframe,也不转移流式连接的所有权。这条规则保证”分析跑到一半窗口动了一下”不会毁掉正在进行的分析。
- 退出语义分离:退出双窗只关闭视觉工作区,参考 trace 和 AI 比较上下文仍然保留;退出对比才会进一步清掉参考 trace、对比上下文和对比会话。
契约层面,CLI 的 smp compare 和前端双窗使用同一套后端比较身份、证据包和报告 section,不存在”CLI 对比结果和网页对比结果不一致”的私有路径。边界也明确:新品语义固定为”当前 trace + 一个 workspace 历史参考 trace”,不兼容任意选择两条历史 trace 比较——那属于多分析结果对照(快照比较)的范畴。
完整操作模型(状态机、边界条件)见仓库 docs/architecture/dual-trace-workspace.md。
三、Quick Mode:证据直答与分析回执
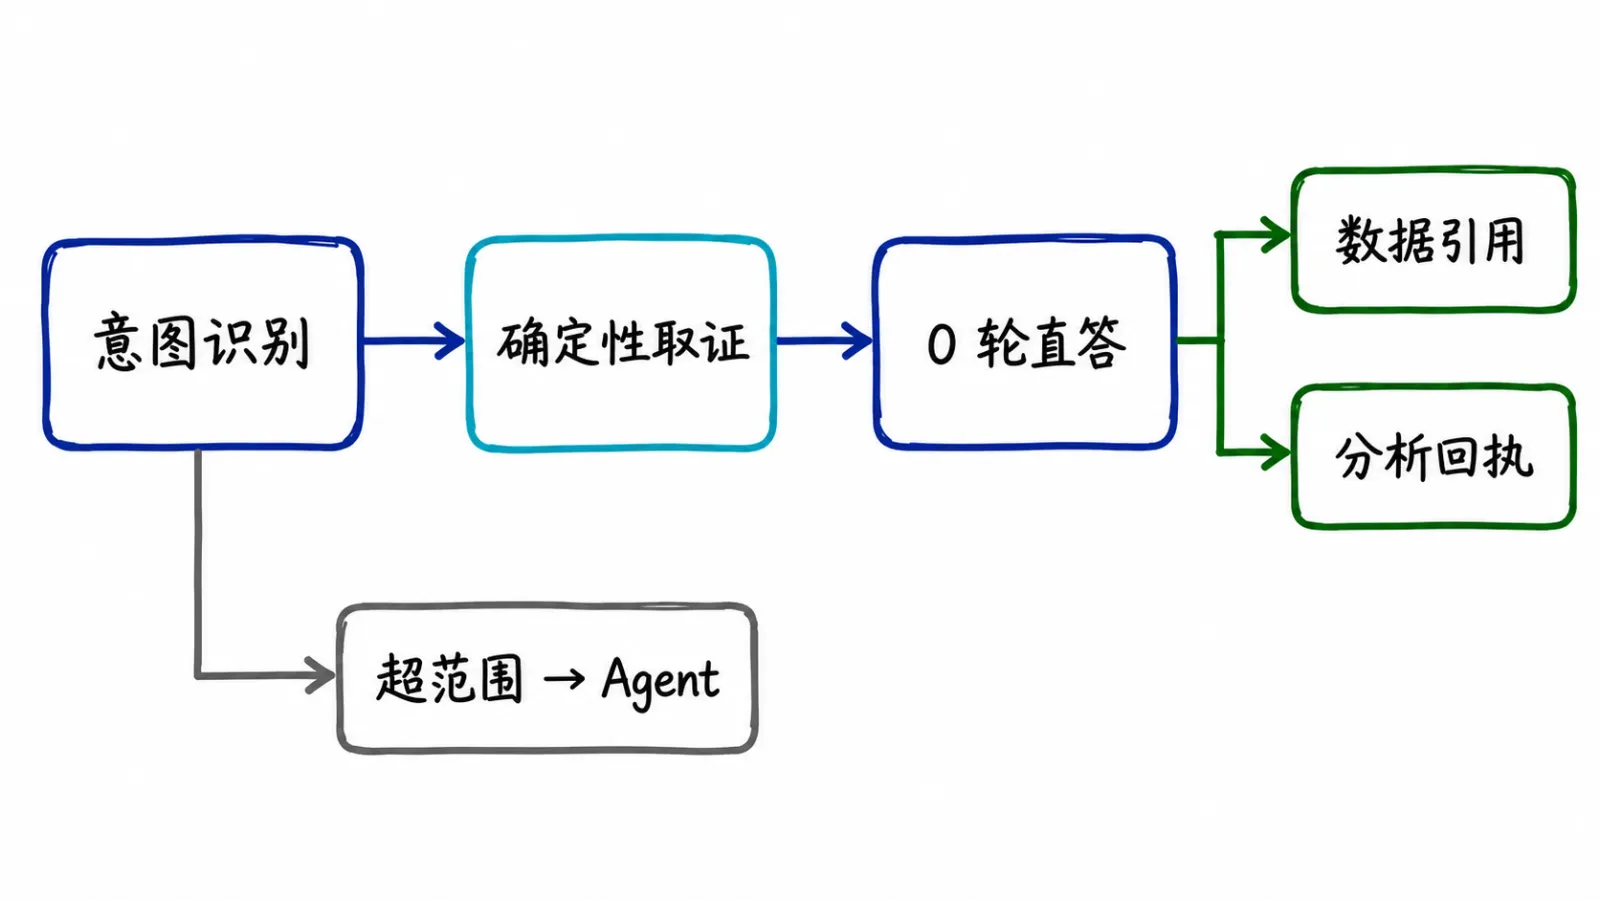
日常使用里有大量状况是事实型的:”帧率是多少”、”前台软件是什么”、”掉帧严重吗”。这类状况走完整的 agent 循环——建计划、多轮工具调用、验证——既慢又浪费 token。这六周把 fast 路径重做成了真正的证据直答商品(6 月 29 日回执商品化,7 月 3 日四运行时对齐,v1.0.38 发布)。
工作方式分三步:
- 意图识别:本地分类器识别问题属于哪类可直答意图——trace 事实(帧数、时长、进程线程)、前台App、滑动流畅度初筛等。混合意图也能处理,例如”帧率是多少?整体流畅吗?”会同时命中 trace 事实和滑动初筛,合并两类证据一起回答。
- 确定性取证:后端直接执行对应的 SQL/Skill 拿证据,不经过模型的工具调用循环。
- 组装直答:用证据表格直接组装答案,附逐句数据引用,0 轮模型对话返回。答案末尾带分析回执,记录用了哪些证据、做工门禁状态。
实际验证用 DeepSeek 真实 API 跑了 9 个端到端用例:身份问题、复合事实、全局帧数加掉帧、滑动初筛、前台应用、CPU 频率存在性、英文提问等,其中 8 个用例实际模型对话轮数为 0,全部通过结论逐条校验(claim verification)。
两个值得说的工程细节:
- 四运行时行为对齐。直答的意图推导、证据组装、结论数目契约在 Claude、OpenAI、Pi Agent Core、OpenCode 四条运行时上收敛到共享模块。此前 Claude 路径是手写组合,混合意图会静默丢掉滑动证据,和其他三条运行时行为不一致;对齐之后这类漂移从结构上消除,结论数目上限这类契约数字也改为模板变量注入,全部单一来源。
- 不误触发。直答只覆盖确定性证据能回答的议题。问题超出范围(例如开放式的”帮我快速分析一下”)会正常落回 agent 路径,不会被硬塞进直答框架里给出残缺答案。
四、私有分析上下文:本机源码 + Android Internals 知识库
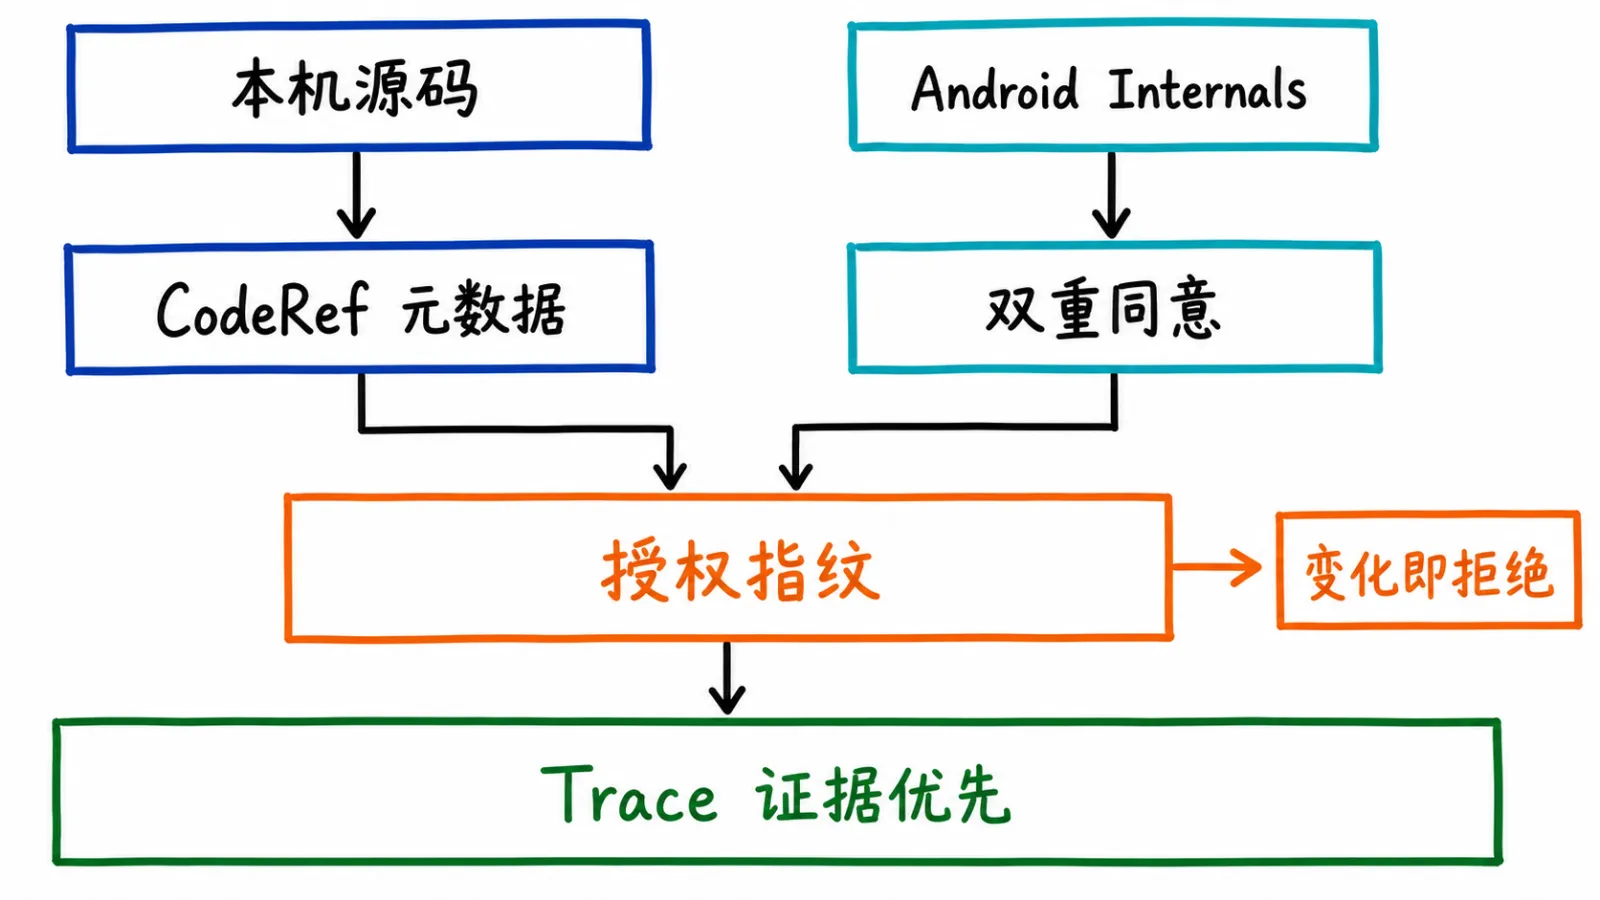
Trace 能告诉你”哪里慢”,但解释”为什么慢”经常要回到源码和系统机制。这六周把两类私有上下文接进了分析链路,并在 v1.1.0 里统一了它们的授权模型。这是版本号从 1.0 跳到 1.1 的主要原因。
本机源码(Code-Aware)。把本机代码库注册进 SmartPerfetto 后,AI 分析可以把 trace 现象定位到具体的类和函数。隐私边界从外观上就收紧:模型看到的是 CodeRef 元数据(chunk id、相对路径、行号范围、符号名),不是源码原文;原文只通过带权限控制的端点供使用者自己查看;metadata_only 和 provider_send 是两档独立同意,前者保证源码片段永远不发给模型厂商。在此基础上还提供补丁建议(patch proposal):AI 只能对已经查找过的源码上下文提修改提议,返回”已验证”级别的补丁前必须先通过 git apply --check。
Android Internals 外部知识库(7 月 14 日)。可以把本机的 android-internals-wiki checkout 注册为版本化的外部知识源。检索链路的约束逐条列出来是这样的:
本文由News整理发布,仅供参考。
