



































SmartPerfetto 开源:面向 Android Trace 分析的 Perfetto AI Assistant
- 滑动卡顿:识别掉帧帧、VSync 超预算、App/SF/GPU 责任侧、主线程和 RenderThread 状态。
- 启动实力:拆分冷启动、温启动、生命周期阶段、主线程耗时、Binder、类加载、GC、IO。
- ANR:定位主线程阻塞、Binder 对端、锁等待、调度延迟和操作系统负载。
- 交互延迟:从 input event 到 frame production,再到 display 的时段分解。
- 内存和 GC:观察 GC pause、内存压力、LMK、dmabuf、系统内存状态。
- 渲染管线:识别 Standard View、Compose、Flutter、WebView、SurfaceView、TextureView、大作、Vulkan 等路径。
它不替代表现工程师。trace 采集品质、业务上下文、设备差异、复现条件仍然要人判断。SmartPerfetto 更像一个能稳定跑 SQL、整理表格、按策略检查遗漏项的分析助手。
运行截图
实际运行时,AI Assistant 可以作为 Perfetto UI 里的浮动窗口出现,也可以和时刻线、场景标记、分析报告一起工作。使用者加载 trace 后,在同一个界面里完成提问、工具调用、证据展开和结论复核。
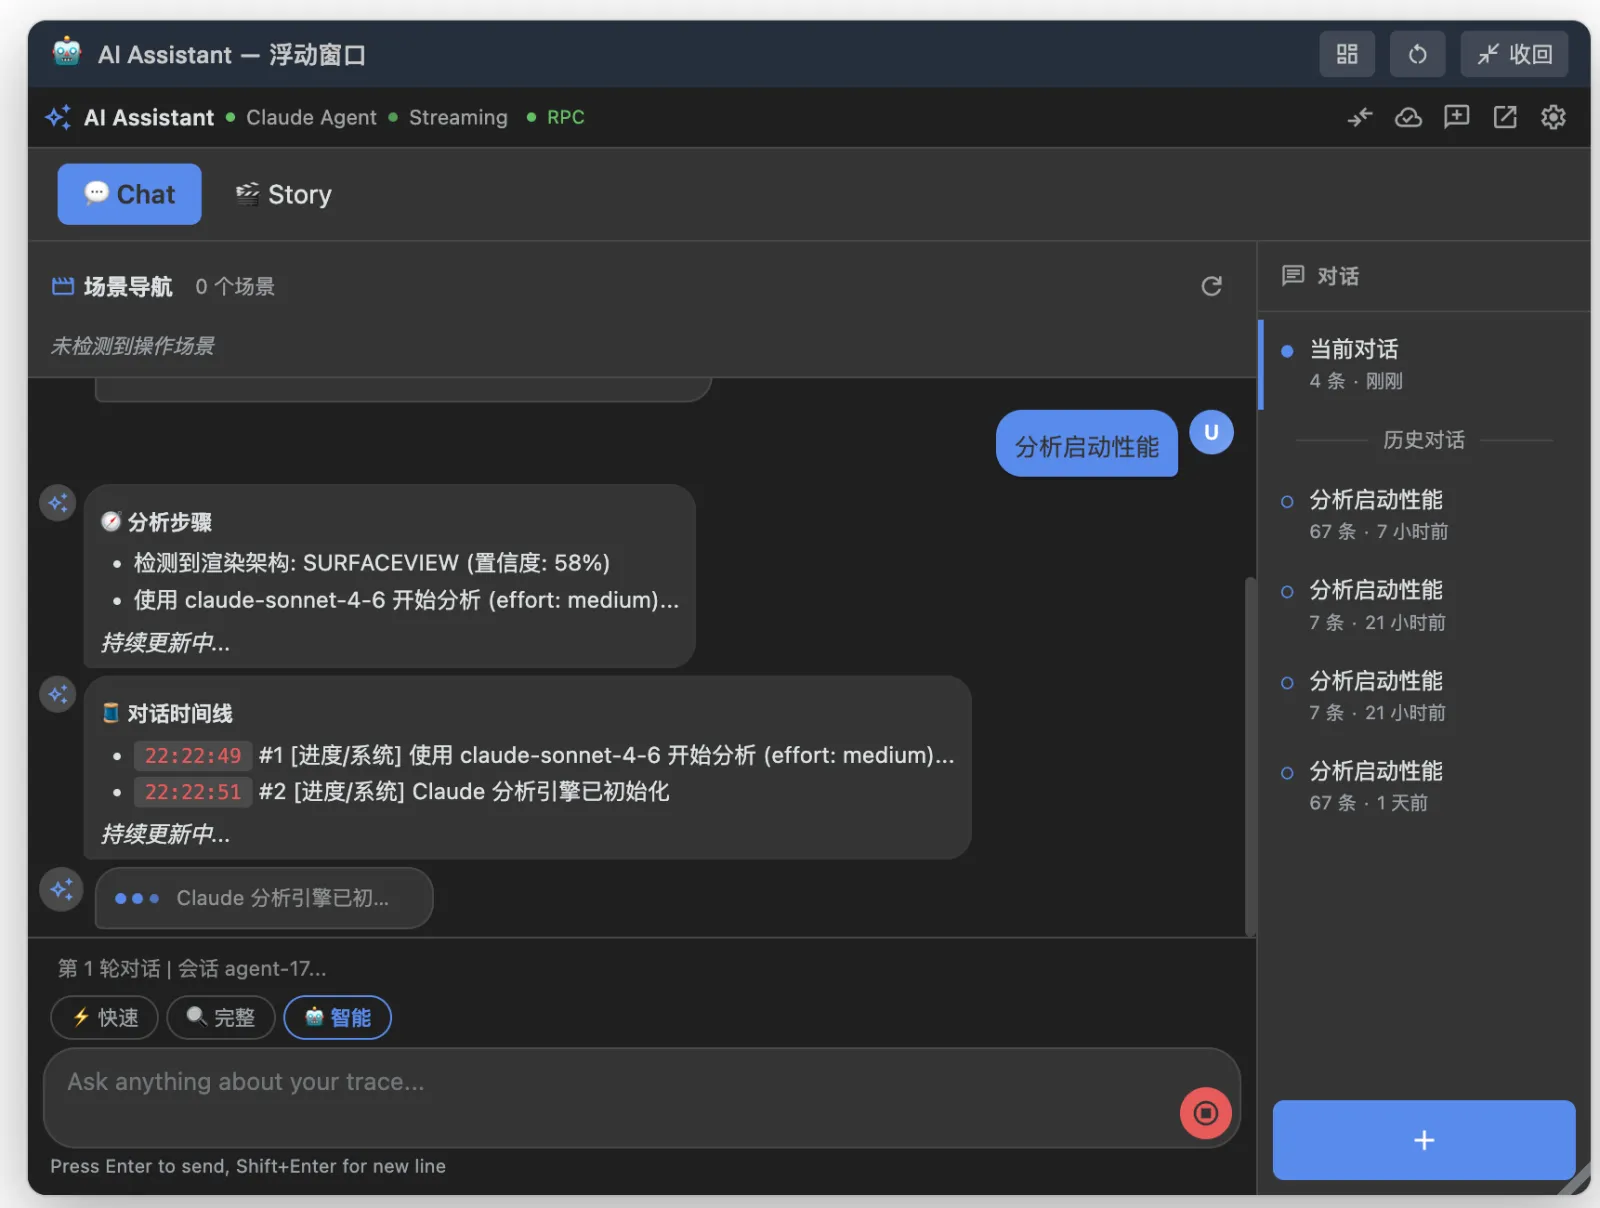
浮动窗口适合在不离开 Perfetto 时间线的情况下追问。窗口里保留当前对话、场景入口、历史会话和输入框,适合边看 trace 边确认下一步分析方向。
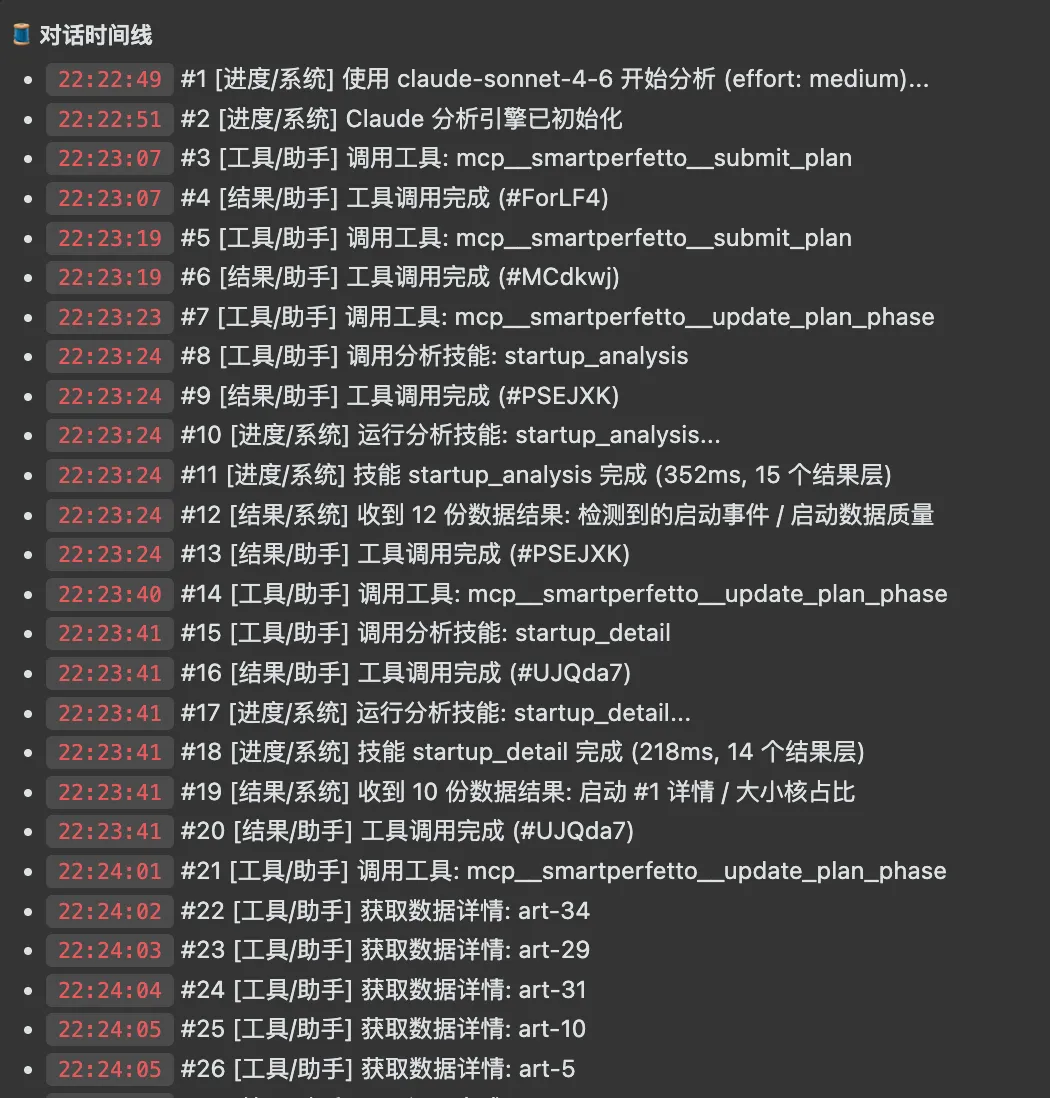
对话时段线会记录 Agent 初始化、规划提交、Skill 调用、SQL 查询和统计结果详情获取。最终结论之外,中间动作也能回看。

分析报告会把启动事件、数字做工、阶段耗时、可疑片段和建议整理到同一份结果里,方便从自然语言结论回到具体证据。
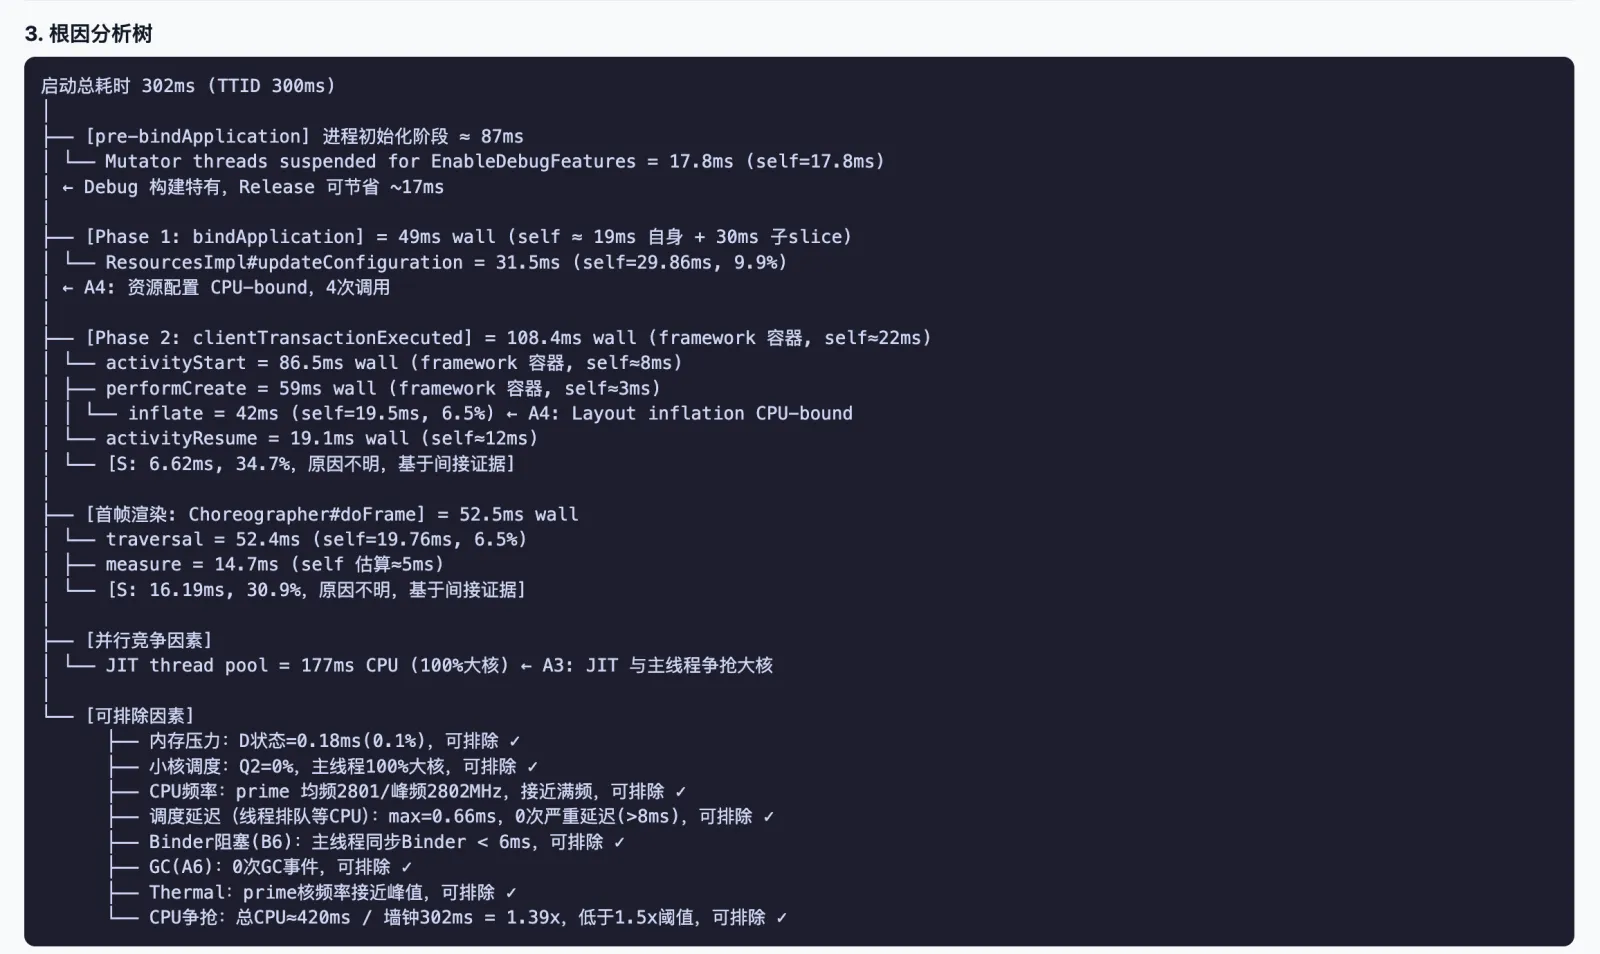
根因定位会尽量把判断落回线程、时刻、SQL 结果和 trace 片段。工程师仍然需要结合业务上下文复核,但不用从空白 SQL 开始翻。
整体架构
SmartPerfetto 的主干架构可以分成三层:前端仍是 Perfetto UI,后端负责编排 Agent 和工具,统计结果查询交给 Perfetto 官方的 trace_processor_shell。
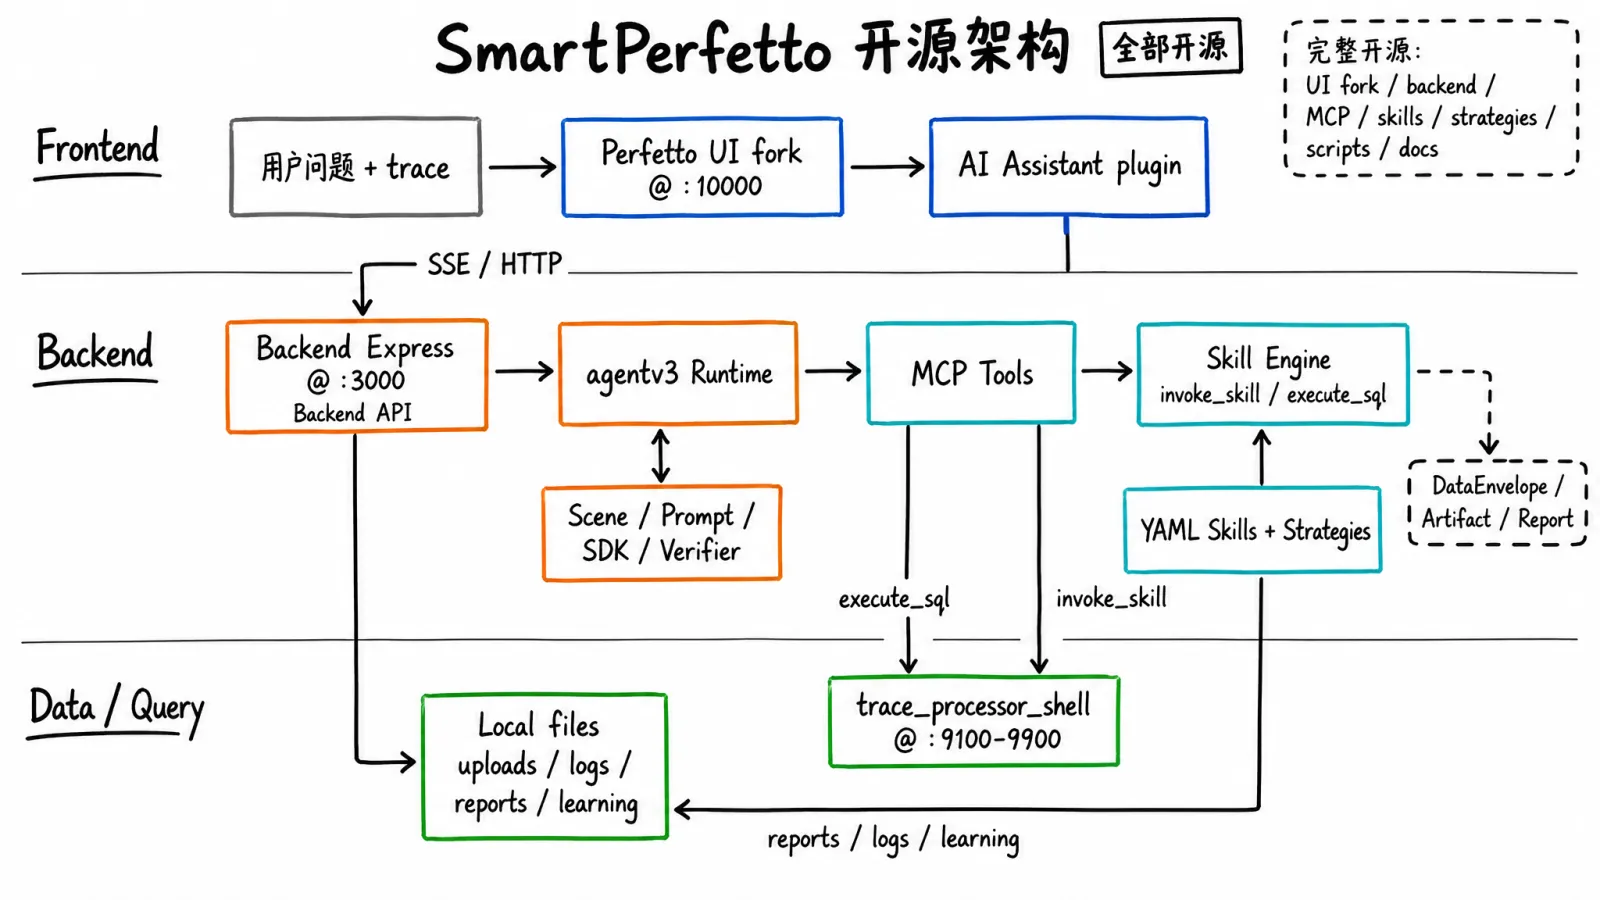
这张架构图里有几条边界要看清:
- 前端不直接分析 trace,只负责加载 trace、展示时间线、发送难题、接收 SSE 事件和渲染结果。
- 后端的
agentv3是主运行时,负责场景识别、Prompt 组装、MCP 工具注册、Verifier 检查和报告生成。 trace_processor_shell仍然是统计结果查询引擎,所有性能数字都来自 SQL 或 Skill 里的确定性计算。- YAML Skill 负责把常见分析流程封装成可复用单元,Agent 不需要每次从零写复杂 SQL。
这个造型背后的判断很直接:大模型适合理解问题、选择方向、组织因果关系;统计结果库和 Skill 适合做查询、统计、分页、格式化和重复执行。
Skill:把表现经验写成可执行分析单元
SmartPerfetto 没有把所有分析逻辑都写进 TypeScript,也没有让大模型自由拼 SQL。大量领域逻辑放在 YAML Skill 里。
一个 Skill 可以声明输入参数、前置表、SQL、显示列、分层输出、条件分支、iterator 和并行步骤。Agent 只需要调用:
1 | invoke_skill("scrolling_analysis", { process_name: "com.example.app" }) |
后端的 Skill Engine 会执行对应的 SQL 和组合步骤,并把结果包装成前端能渲染的 DataEnvelope。这样做有三个好处:

- 结果可重复:同一个 trace、同一组参数,Skill 的计算路径稳定。
- 输出可展示:列名、统计结果类型、时刻戳跳转、duration 格式化都在 Skill 里声明。
- 贡献成本低:熟悉 Perfetto SQL 的实力工程师可以改 YAML 和 SQL,不必先理解完整后端代码。
当前 Skill 分布是:
| 类型 | 规模 | 位置 | 用途 |
|---|---|---|---|
| Atomic | 87 | backend/skills/atomic/ | 单项 SQL 查询,例如 CPU 频率、Binder、GC、FrameTimeline |
| Composite | 29 | backend/skills/composite/ | 多步骤分析,例如 scrolling_analysis、startup_analysis、anr_analysis |
| Deep | 2 | backend/skills/deep/ | 调用栈和 CPU profiling 等深度分析 |
| Pipeline | 29 | backend/skills/pipelines/ | 渲染管线检测和教学内容 |
| Module | 18 | backend/skills/modules/ | app/framework/kernel/hardware 分层专家模块 |
这套 Skill 系统属于 SmartPerfetto 运行时能力,和研发工具里的 Skill 分开看。Claude Code Skill 帮开发者写 SmartPerfetto;SmartPerfetto YAML Skill 帮用户分析 trace。两者名字相近,运行位置、输入输出和方向都不同。
MCP:让 Agent 只通过工具接触 trace
SmartPerfetto 通过 MCP (Model Context Protocol) 给 Agent 暴露工具。Full 模式下最多 20 个工具,Fast 模式下只保留 3 个轻量工具。
常用工具分几类:
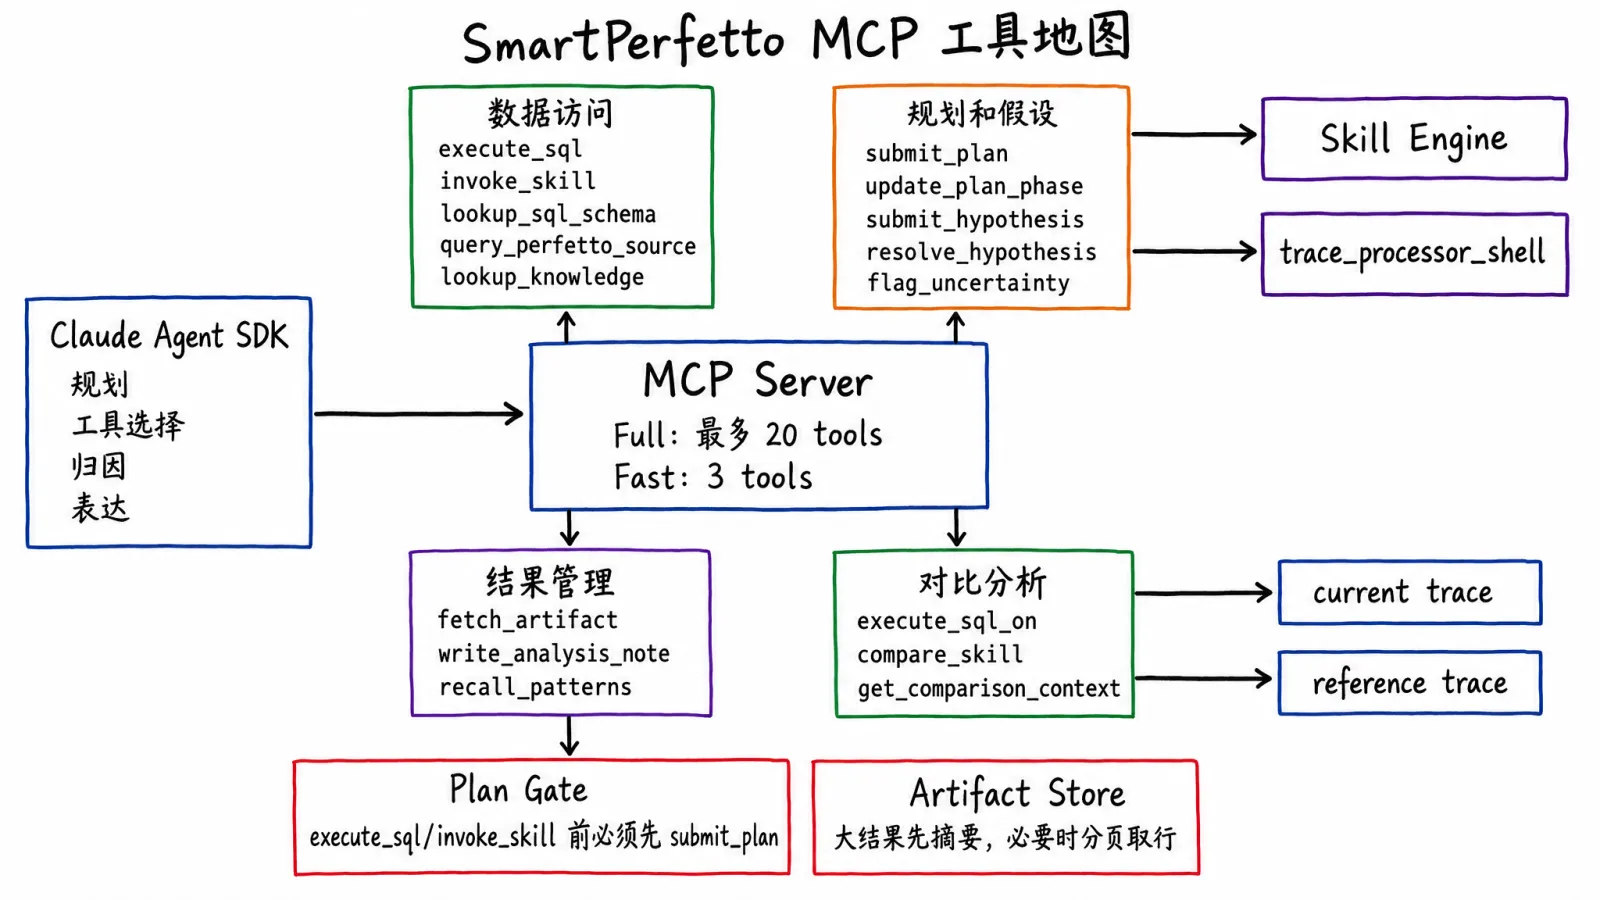
- 数据访问:
execute_sql、invoke_skill、list_skills、lookup_sql_schema、query_perfetto_source、list_stdlib_modules、lookup_knowledge、detect_architecture。 - 规划和假设:
submit_plan、update_plan_phase、revise_plan、submit_hypothesis、resolve_hypothesis、flag_uncertainty。 - 结果管理:
fetch_artifact、write_analysis_note、recall_patterns。 - 比较分析:
execute_sql_on、compare_skill、get_comparison_context。
其中 execute_sql 和 invoke_skill 有计划门控。Agent 必须先提交分析规划,才能开始查数据。这个门控不追求把流程写死,而是要求 Agent 在动手前声明阶段、目标和预期工具,后续 Verifier 再检查关键动作是否缺失。
工具返回的统计结果也会被压缩和分层。大结果会进入 Artifact Store,Agent 先拿摘要,必要时再分页取行。这样可以避免一次 Skill 输出几十万 token,把上下文耗尽。
从提问到结论的流程
用户输入一句「分析滑动卡顿」后,SmartPerfetto 不会直接把 trace 发给大模型。trace 文件不会进入 prompt,Agent 接触到的是工具返回的结构化结果。
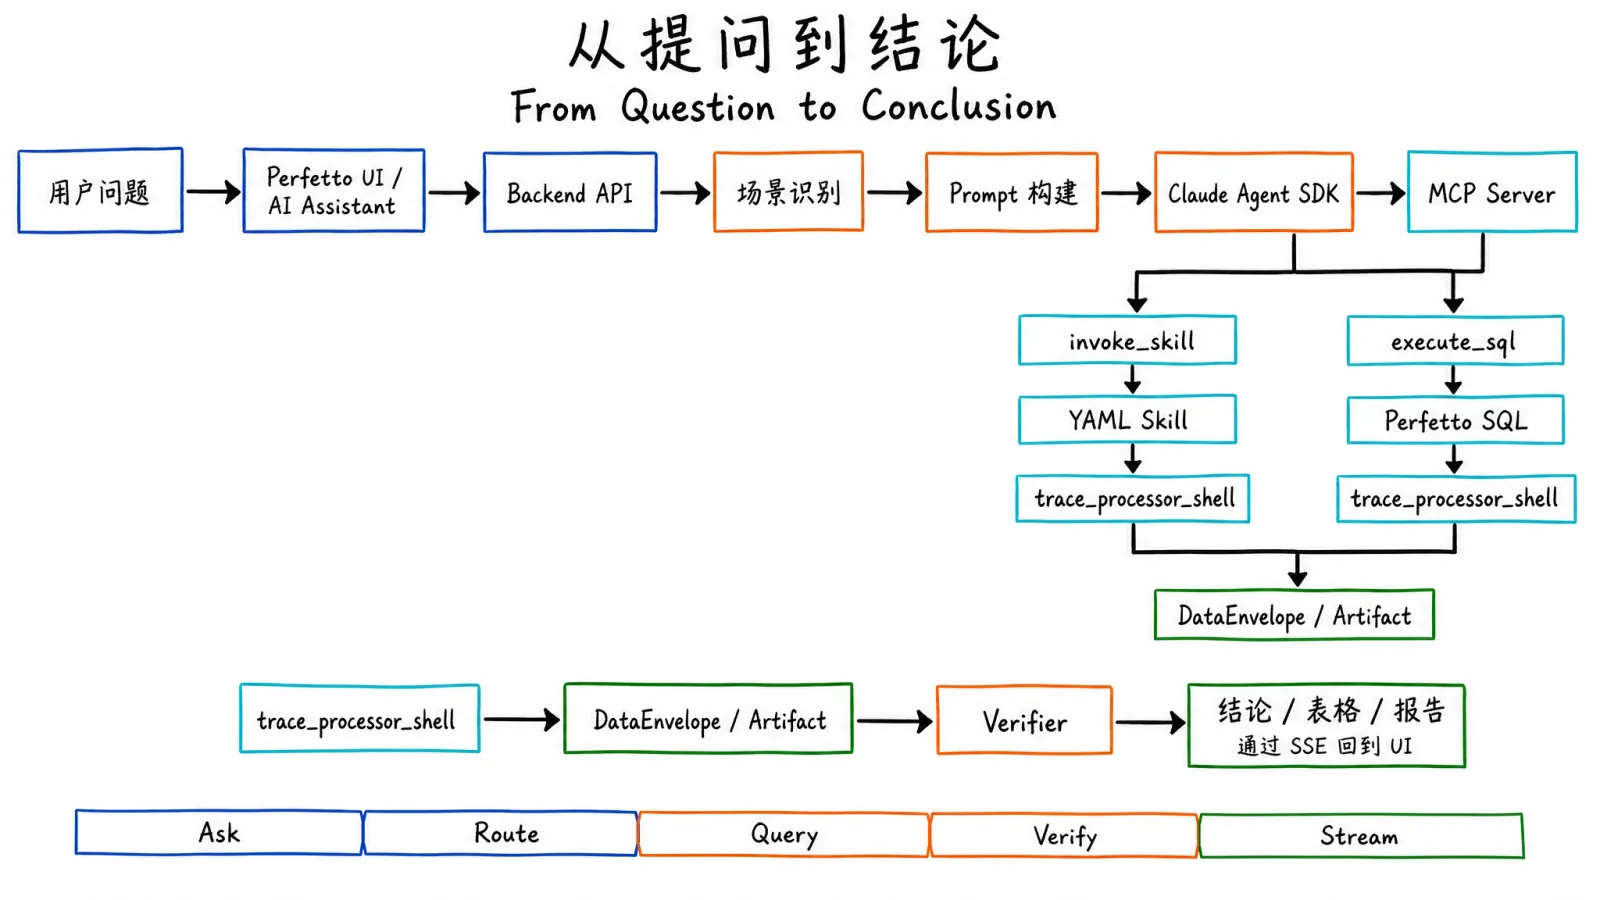
一条滑动卡顿分析通常会经过这些步骤:
本文由News整理发布,仅供参考。
