



































公告
GPT-6 Astra 爆改Qwen 大脑:只动0.016% 参数,数学成绩疯涨
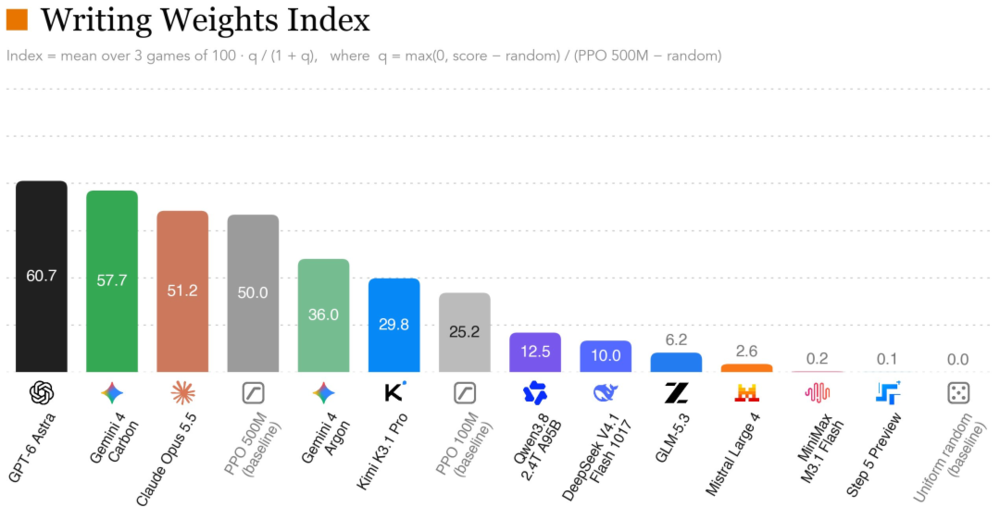
关于读写权重的争议,也是另一个争议点。普林斯顿大学博士生Xingyu Dang在运行一项Writing Weights Index测试后报告,开源模型在这类任务上表现困难。这也意味着,读写权重可能主要是最新前沿模型刚刚展现的能力,而不是所有大语言模型都已经具备的通用技能。
原博客本身也记录了一项主要的失败,在识别「谄媚模型」的实验中,Astra仅比较权重时无法作出判断,直到被允许观察模型在特定文本上的注意力模式,才识别出差异。这说明「直接读懂权重」目前仍不是稳定、通用的能力。
人人都能发布大模型
这项工作并没有让我改变对老派机制可解释表现走多远的判断,它改变的是我对大模型有多擅长这件事的判断。
过去,研究人员想要改变一个模型的行为,通常需要准备统计结果、外观训练方式,再通过优化算法更新权重。现在,GPT-6 Astra展示了另一种可能:让大模型根据任务目的,分析神经网络内部的参数,并尝试直接修改它们。
当然,距离真正把这种方式用到实际的模型打造中,还有不少议题需要解决。
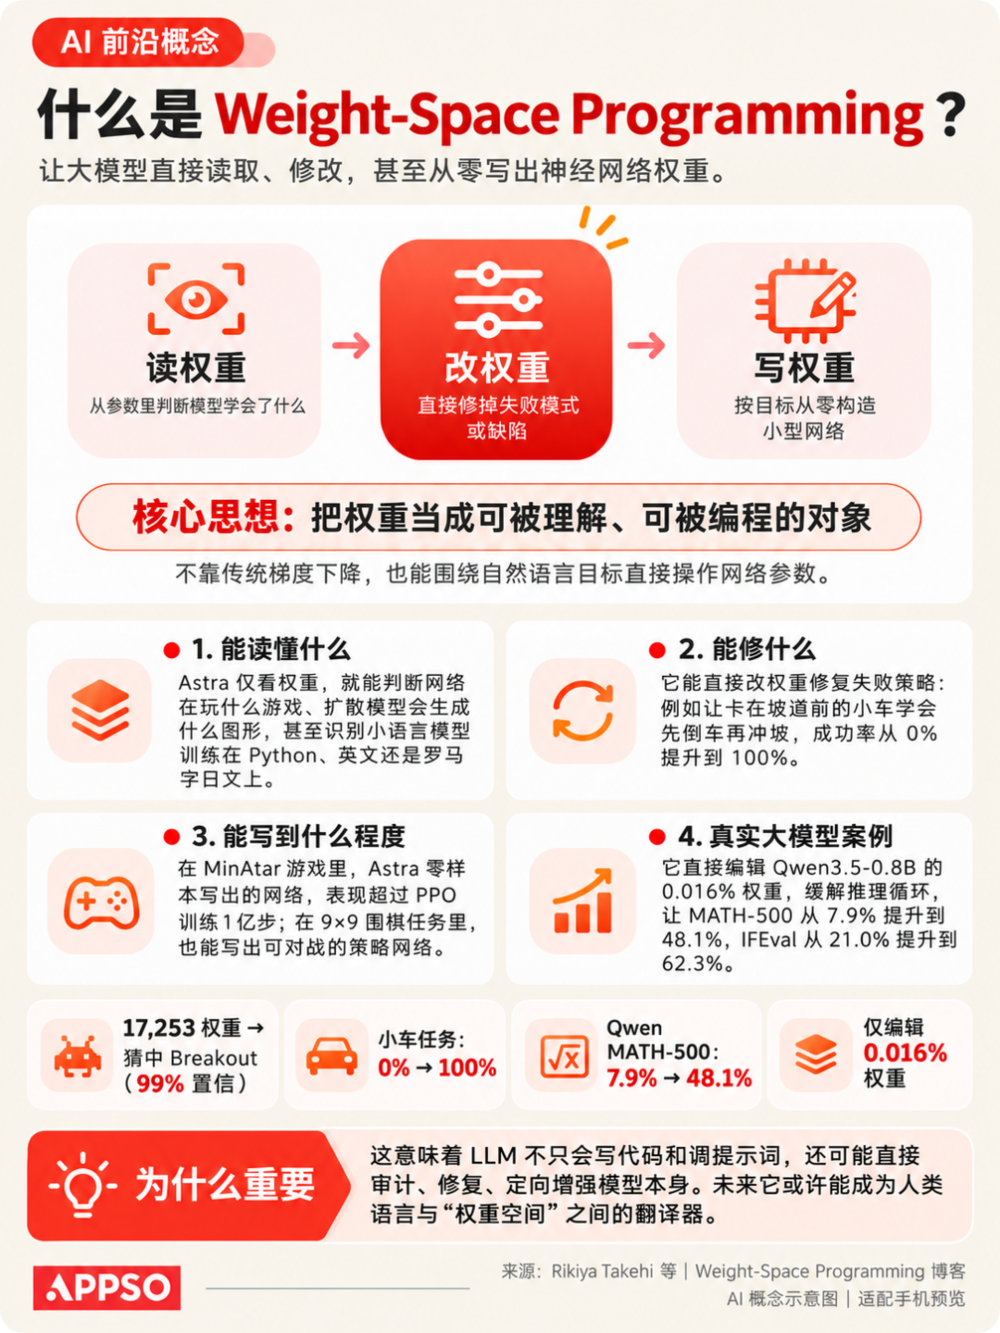
这次Astra成功修复了Qwen的推理循环,却没能明显改善Gemma的数学表现。它能否稳定适用于不同模型和任务?与关闭思考模式、常规微调相比,究竟有多大优势?更重要的是,它能否让模型获得原本不具备的能力,还是只能修复已有能力发挥过程中的问题?
但是当神经网络的权重本身,也可能成为大模型可以直接操作的编程对象时;未来,我们或许只需要描述希望模型具备什么行为,AI就尝试把这些要求转化为具体的参数修改。
本文由News整理发布,仅供参考。
评论加载中…
