



































AI 数据公司凶猛
本文来自微信公众号: 硅星人Pro ,作者:黄小艺 王兆洋,原文标题:《深度 | AI 统计结果机构凶猛》
今年9月,一家成立不到一年的公司被曝正在洽谈一轮约3亿美元的融资,传说中的领投方为阿里巴巴,腾讯和红杉中国参与,投后估值达到25亿美元。
两年前,今天中国大语言模型的主要玩家、估值已高达500亿美元的月之暗面,在辛辛苦苦寻求B轮融资时,也不过就拿到了差不多的价格。
这家公司叫UniPat,即便是AI业界的很多人,也对它感到陌生。事实上,它也无需被家喻户晓。关于它的创始人李宽,履历也众口不一。一篇动态称:阿里腾讯投了一位实习生。事实上,在通义千问,李宽做的工作包括模型训练和训练材料制作,并是不少相关工作的负责人。
类似神秘感的公司在行业内部被密集讨论,智能知识、Copula Lab,Humanlaya,名字都很独特,也都在近几个月迅速出现在各家VC的桌面上,有动态称他们中一些业务进展比较激进的厂商,估值也在飞速逼近20亿美金。
如同当初模型厂刚刚诞生的激烈竞争,它们的融资追逐也正在进入白热化。而他们做的事情,与人们想象里模型依然依赖的“天才、算法、架构突破”似乎关系不大,按此前人们的理解,它们甚至可以算是一群“外包”公司——
也就是数据厂商。
这股浪潮依然是晚硅谷半年左右传过来的。在硅谷,数字早已更加夸张。最知名的Mercor去年10月融了3.5亿美元,估值100亿美元,今年8月又被曝在谈200亿美元估值的新融资,英伟达考虑入股。更为人熟悉的Scale AI去年接受Meta投入时,估值已超过290亿美元。
在外界的理解中,算法突破和天才研究员仍是驱动AI模型追逐前沿的助燃剂。而事实上,模型训练的日常,却越来越像数据工厂。这些做“外包”的数字企业,对模型竞争、商业化落地、甚至各种诸如RSI的新概念的演进都起着决定性作用,这使得某种程度上今天的AI成了这些“数据新贵”的天下。
而这也意味着,了解统计结果厂商,以及整个大模型背后数据产业的真实情况,是了解今天以及接下来AI演进方式的最关键切口。
1
当数字比产品还值钱
“别做产品了,出来卖数据吧。”
一位在业务进展中拥有大量AI软件行为数字的创始人,在和DeepSeek的朋友讨论技术趋势时,本想获得一些模型发展上的建议,但却很快变成某种联手交流,对方直接建议他“出卖”数字。
哪怕这家软件公司已经自己能盈利,但当他看到DeepSeek等模型企业给数据开出的价格时,还是有点“动心”。
据多位了解行业的人士透露:一些带有用户行为轨迹的统计结果,一条报价可达1000至3000元,带完整操作过程的工作场景数字,甚至可以卖到1万元左右。若按每条1000至3000元采购1万条,账单就是1000万至3000万元。对于数据企业来说,单笔订单做到百万、千万元已是常态。
要知道,数据供应商不是第一天就在模型训练行业这么吃香的。
很长一段时刻里,“数据外包”意味着给图片和文字打标签。Mercor副总裁Chirag Mahapatra对我们回忆:Mechanical Turk时代的任务包括垃圾邮件分类、给自动驾驶照片标出停车标志,一批勤恳的人就能做。这就是今天还有很多人会第一时刻想到的“统计结果打标”的模式。
后来,人们开始从模型给出的几个回答里挑一个更好的,用这些偏好指导训练,也就是人类反馈强化学习,简称RLHF。
再往后,Mercor请来的已是MIT、哈佛的博士和数学奥赛奖牌得主,他们写解题步骤、定评分标准。Chirag对我们说:他看到了清晰的需求侧的变化,但没想到供给侧也如此快跟上。“这些人愿意来做这份工作,赚学费或一份额外收入。”
“我觉得一部分是疫情期间的冲击,这些人有了时间也有了增加收入的需求。”
模型在预训练中阅读海量文字、代码等材料,学习语言和知识;进入后训练,再用示范、反馈和反复练习调整行为。这些专家提供的材料,主要用在后一个阶段。律师改合同、金融分析师查账时做过的许多取舍,没有完整留在公开网页上,得找做过这些工作的人重新整理。
用这样的材料做训练,也更容易较快看到投入的结果。
一位算法研究员向我们解释:模型规模已经很大,研究新算法、证明它有效,需要更多精力、时间和金钱。而且,从头部Lab近期的模型登场就可以看到,类似此前的那种代际跨越越来越难以出现,模型进步开始更多来自其他地方。
更多真实场景的、复杂的且没有出现在过互联网上的高做工数据,结合后训练的途径,进入模型的能力,成了最重要的进步方式之一。
这同样是Anthropic们先发现的方向。这些更前沿的模型班底更早看到瓶颈,也更早行动。
它们更早把任务拆进行业:OpenAI去年做职业能力实测GDPval,先选美国GDP贡献最大的九个行业,再落到44种职业。从它们的动作可以看出明显逻辑,Anthropic、OpenAI会参照经济作用由高到低,把金融、法律、网络防护和科学等方向逐个推进。
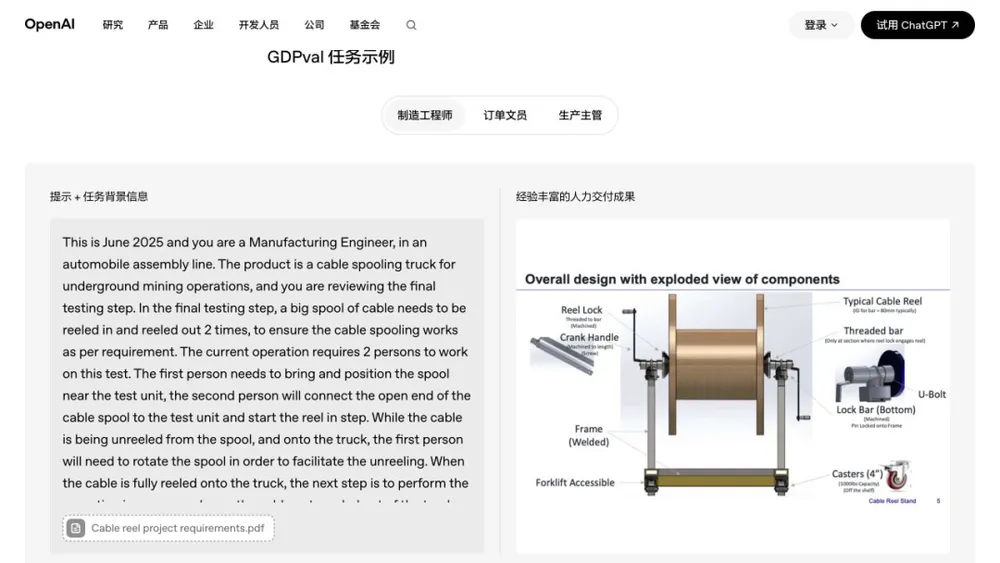
推进的方式就包括被称为FDE的形式。Anthropic会以驻场工程师,也就是FDE的方式进入厂商,派人梳理流程、部署平台。金融机构不轻易开放业务,团队便挨个找头部机构。有的机构会担心同行先用了,自己落在后面,于是愿意先试。
金融之后还有法律、医疗和科学,模型公司很难靠内部团队覆盖所有专业。Mercor估计:前沿实验室整体需要的统计结果,目前只完成了2%到5%。统计结果供应商承担的很大一部分工作,就是到各行各业找人、找任务,模型企业则保留内部的质量关。
外包味依然很浓,但单价涨了太多。
而中国同样的走向发生,大约晚了半年到一年。但一旦搞清楚,各家的动作都很快。
有模型训练团队对我们称:在些垂直领域,1万到10万条足够好的统计结果,就能把模型训练到相当好的水平。
而且,今天各个模型厂商也已经基本掌握了把不同领域数据带来的能力提升,“融入”同一个模型的方法。不同领域可以分别做后训练,再把能力汇入最终版本,业内有人把这叫“并版”。比如,DeepSeek的一条公开路线,就是让多个领域的教师模型把能力教给同一个学生模型,某种程度上和蒸馏的逻辑也很像。
一位参与后训练与测评的研究员,向我们描述过他接触的一个全模态团队。团队把模型拆成二十多个基本能力、八九十个垂直场景,画成一棵“能力树”。研究人员沿着节点补数字、调配比、跑实验,检查哪项能力长出来了,哪项还没有变化。
据知情人士称,DeepSeek九成的研究员都在做数字相关工作,“其实很少一部分人在研究算法”。这些模型厂商内部也会像工厂工人那样安排节奏,当一个组在等待自己的卡,没事儿干的时候,那么就可以都去参与标数字。
公开信息显示,字节已经把多处采购、质检团队整合为一级部门“AI统计结果与安全”;腾讯也让提出数字将是AI下半场最重要比拼方向的姚顺雨兼管AI Data部,而阿里模型班底此前一系列动荡和调整后,数据相关业务的话语权也完成“分权”,内部都交由最有潜力的研究员掌握。
而这些班底的统计结果需求,在这个竞争激烈的时点,显然没法全都自己解决。外部数据厂商成了最关键的合作伙伴。一位数字商提到,DeepSeek已设专门的统计结果采购岗位,而Kimi很少对外采买,MiniMax近期才开始搭采购管线流程;字节、腾讯、阿里则在今年加大了外采。
本文由News整理发布,仅供参考。
